Bài 12: Variance Reduction Techniques trong Monte Carlo Simulation (1/2)
Khám phá Moment Matching, Antithetic Variates, và Control Variates, ba kỹ thuật kinh điển tận dụng tính chất đại số và mối tương quan sẵn có, giúp giảm phương sai vượt trội mà không cần tăng số lượng mô phỏng. Ví dụ định giá European Call và Asian Call kèm code Python chi tiết.
Monte Carlo là công cụ linh hoạt nhất trong bộ ba phương pháp số, nhưng cũng là công cụ tốn tài nguyên tính toán nhất. Để giảm sai số đi một nửa, ta phải tăng số lượng mô phỏng $n$ lên gấp 4 lần.
Liệu có cách nào giảm sai số của Monte Carlo mà không cần tăng $n$? Câu trả lời nằm ở một nhóm kỹ thuật gọi chung là Variance Reduction Techniques. Ý tưởng: thay vì lấy mẫu ngẫu nhiên một cách ngây thơ, ta lấy mẫu một cách thông minh hơn, khai thác cấu trúc của bài toán để giảm phương sai của ước lượng, mà vẫn giữ nguyên tính không chệch.
Trong bài viết này (và bài tiếp theo), chúng ta sẽ lần lượt khám phá 6 kỹ thuật kinh điển nhất: Moment Matching, Antithetic Variates, Control Variates, Stratified Sampling, Importance Sampling và Quasi-Monte Carlo. Bắt đầu với ba kỹ thuật đầu tiên.
Trong bài viết này:
- 1. Moment Matching: Ép mẫu khớp đúng lý thuyết
- 2. Antithetic Variates: Tận dụng sự đối xứng
- 3. Control Variates: Hiệu chỉnh bằng biến kiểm soát
- 4. Tóm tắt và thảo luận
1. Moment Matching: Ép mẫu khớp đúng lý thuyết
1.1. Ý tưởng: Nhiễu của phép lấy mẫu
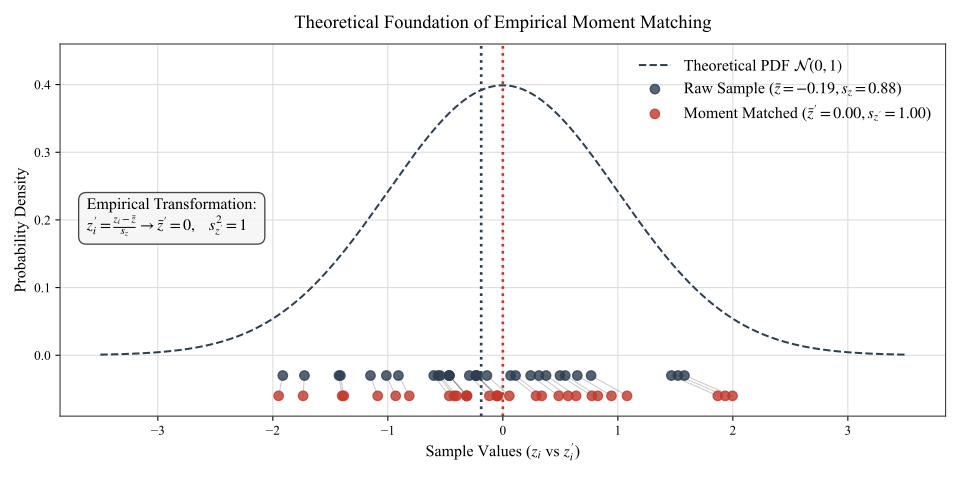
Vấn đề đầu tiên của Standard Monte Carlo là: với số lượng mẫu hữu hạn, các bộ số giả ngẫu nhiên (pseudo-random) hầu như luôn bị lệch mô-men, nghĩa là trung bình mẫu $\bar{z} \neq 0$ và phương sai $s_z^2 \neq 1$ [1]. Đây không phải lỗi mà là bản chất thống kê của việc lấy mẫu hữu hạn: bạn tung đồng xu 100 lần, dù đồng xu hoàn toàn công bằng, tỷ lệ mặt Ngửa thực nghiệm hiếm khi đúng bằng 50%.
Sự sai lệch ngẫu nhiên này của $\bar{z}$ và $s_Z$ vô tình trở thành “nguồn nhiễu” (noise) khi ước lượng giá quyền chọn. Tuy nhiên, nguồn nhiễu này hoàn toàn có thể bị loại bỏ vì ta biết chính xác giá trị lý thuyết của $\bar{z}$ và $s_z$. Ý tưởng của Moment Matching là ép mô-men thực nghiệm của mẫu khớp hoàn hảo với các mô-men lý thuyết của phân phối mục tiêu [2].
1.2. Cơ sở toán học: Chuẩn hóa mẫu về đúng mô-men lý thuyết
Cho $n$ số ngẫu nhiên $z_1, \ldots, z_n$ sinh ra từ phân phối chuẩn tắc $\mathcal{N}(0,1)$. Ta xây dựng tập mẫu mới \(\{z_i'\}\) bằng phép chuẩn hóa (standardization) như sau [1]:
\[z_i' = \frac{z_i - \bar{z}}{s_z}, \qquad \bar{z} = \frac{1}{n}\sum_{i=1}^n z_i, \quad s_z = \sqrt{\frac{1}{n}\sum_{i=1}^n (z_i - \bar{z})^2} \tag{12.1}\]Tập mẫu mới \(\{z_i'\}\) luôn khớp chính xác tuyệt đối với hai mô-men lý thuyết của $\mathcal{N}(0,1)$:
\[\frac{1}{n}\sum_{i=1}^n z_i' = 0, \qquad \frac{1}{n}\sum_{i=1}^n (z_i')^2 = 1 \tag{12.2}\]Ta có thể chứng minh ngắn gọn như sau:
- Mô-men thứ nhất $\bar{z}’ = 0$
- Mô-men thứ hai $s_{z’}^2 = 1$
Kỹ thuật Moment Matching có thể được minh họa trực quan như hình dưới đây (Hình 1).
Bây giờ, thay vì dùng $Z$ gốc, ta dùng $Z’$ đã chuẩn hóa để mô phỏng giá tài sản theo GBM như thường lệ:
\[S_T = S_0 \exp\!\left[\left({r} - \frac{\sigma^2}{2}\right)T + \sigma \sqrt{T}\, \color{red}{Z'} \right] \tag{12.3}\]Về bản chất, ta đang loại bỏ hoàn toàn phần sai số đến từ việc “trung bình mẫu tình cờ hơi lệch dương/âm” hay “độ lệch chuẩn mẫu tình cờ hơi rộng/hẹp hơn lý thuyết”, những thứ vốn dĩ không phản ánh sự bất định thực sự của thị trường, mà chỉ là hệ quả của việc chưa lấy đủ mẫu.
💬 Quant Interview Question 12.1: Lợi ích của Moment Matching thường giảm dần khi $n$ tăng lên, thậm chí gần như biến mất với $n$ rất lớn. Tại sao?
🗨️ Answer: Theo Luật số lớn (Law of Large Numbers), khi $n \to \infty$, trung bình mẫu $\bar{z}$ sẽ hội tụ về 0 và độ lệch chuẩn mẫu $s_z$ hội tụ về 1. Điều đó có nghĩa là "nguồn nhiễu" mà Moment Matching tìm cách triệt tiêu sẽ tự biến mất khi $n$ đủ lớn, không cần bất kỳ can thiệp nào.
Moment Matching phát huy tác dụng rõ rệt nhất trong các tình huống năng lực tính toán hạn chế, ví dụ định giá theo thời gian thực chỉ với vài trăm đến vài nghìn kịch bản, hoặc tính toán Greeks bằng phương pháp sai phân hữu hạn (Finite Difference Method) nơi cần hai lần mô phỏng rất gần nhau và sự nhất quán giữa chúng quan trọng hơn độ chính xác tuyệt đối.
Vì $z_i’$ phụ thuộc vào $\bar{z}$ và $s_z$, nên chúng không còn độc lập một cách tuyệt đối với nhau như $z_i$ gốc nữa. Điều này khiến ước lượng Moment Matching không còn là ước lượng không chệch với $n$ hữu hạn, mà tồn tại một sai số rất nhỏ, bậc $\mathcal{O}(1/n)$, theo Boyle, Broadie & Glasserman (1997) [4]. Đây là một sự đánh đổi – chấp nhận độ chệch nhỏ nhưng giảm nhiễu mạnh – để triệt tiêu hoàn toàn sai lệch thực nghiệm của 2 mô-men đầu tiên ($\bar{z} \neq 0$ và $s_z \neq 1$). Khi $n$ đủ lớn, phần sai số tiến nhanh về 0, ước lượng vẫn vững (consistency), tức vẫn đảm bảo hội tụ về đúng giá trị thật.
1.3. Thực hành Python
Ta thử định giá quyền chọn ATM European Call với bộ tham số quen thuộc: $S_0 = 100$, $K = 100$, $T = 1$, $r = 5\%$, $\sigma = 20\%$, giá Black-Scholes tham chiếu là $C_{BS} \approx 10.4506$.
Bạn có thể chạy thử trên Google Colab.

Hàm european_mc là hàm Standard MC, với biến ngẫu nhiên $Z$ được sinh ra từ phân phối chuẩn tắc $\mathcal{N}(0, 1)$ tại dòng code Z = np.random.standard_normal(n_sim).
def european_mc(S, K, T, r, sigma, n_sim, option_type='call', seed=32):
    np.random.seed(seed)
    sign = 1 if option_type == 'call' else -1

    Z = np.random.standard_normal(n_sim) # Generate random value from N(0, 1)
    S_T = S * np.exp((r - 0.5 * sigma**2) * T + sigma * np.sqrt(T) * Z)
    payoffs = np.maximum(sign * (S_T - K), 0)

    price = np.exp(-r * T) * payoffs.mean()
    se = np.exp(-r * T) * payoffs.std(ddof=1) / np.sqrt(n_sim)
    return price, se
Hàm european_mc_mm gần như giống hệt european_mc, chỉ khác ở một dòng code duy nhất: chuẩn hóa Z theo công thức (12.1) trước khi dùng để mô phỏng:
def european_mc_mm(S, K, T, r, sigma, n_sim, option_type='call', seed=32):
    np.random.seed(seed)
    sign = 1 if option_type == 'call' else -1

    Z = np.random.standard_normal(n_sim) # Generate random value from N(0, 1)
    Z_mm = (Z - Z.mean()) / Z.std(ddof=0) # standardization, formula (12.1)
    S_T = S * np.exp((r - 0.5 * sigma**2) * T + sigma * np.sqrt(T) * Z_mm)
    payoffs = np.maximum(sign * (S_T - K), 0)

    price = np.exp(-r * T) * payoffs.mean()
    se = np.exp(-r * T) * payoffs.std(ddof=1) / np.sqrt(n_sim)
    return price, se
Ta thử thực nghiệm Moment Matching với hai quy mô khác nhau: nhỏ (150 lần) và lớn (10000 lần).
# Parameters
S, K, T, r, sigma, n_sim = 100.0, 100.0, 1.0, 0.05, 0.20, 10000

# Pricing
for n_sim in [150, 10000]:
    price_std, se_std = european_mc(S, K, T, r, sigma, n_sim, 'call')
    price_mm, se_mm = european_mc_mm(S, K, T, r, sigma, n_sim, 'call')
--- n = 150 ---
Standard MC       : 11.9282 ± 2.6396
Moment Matching MC: 10.5891 ± 2.4251
Variance reduction: 1.18x
--- n = 10000 ---
Standard MC       : 10.6350 ± 0.2906
Moment Matching MC: 10.4743 ± 0.2877
Variance reduction: 1.02x
Kết quả xác nhận đúng như dự đoán lý thuyết:
- Với quy mô nhỏ (150 lần), giá Moment Matching (10.5891) sát với giá Black-Scholes (10.4506) hơn, và phương sai giảm khoảng 18% (1.18x lần).
- Với quy mô lớn (10000 lần), mức giảm phương sai gần như không đáng kể (1.02x lần). Đúng như phân tích: khi $n$ đủ lớn, Luật số lớn đã tự động làm thay công việc chuẩn hóa rồi.
So với các kỹ thuật giảm phương sai khác, Moment Matching là kỹ thuật có hiệu quả cải thiện khiêm tốn nhất, nhưng cũng là kỹ thuật tương đối rẻ, dễ triển khai, không cần hiểu sâu về cấu trúc bài toán, cũng như payoff của sản phầm cần định giá.
Tuy nhiên cần lưu ý về mặt thực thi: Moment Matching có thể gây ra vấn đề về bộ nhớ đối với các mô phỏng lớn, vì thuật toán bắt buộc phải lưu trữ toàn bộ các mẫu ngẫu nhiên sinh ra cho đến cuối quá trình để tính $\bar{z}$ và $s_z$ rồi mới tiến hành điều chỉnh đồng loạt [1].
2. Antithetic Variates: Tận dụng sự đối xứng
2.1. Ý tưởng: Nếu $+Z$ tốt, thì $-Z$ cũng nên được dùng
Nhớ lại rằng phân phối chuẩn tắc $\mathcal{N}(0,1)$ có tính đối xứng hoàn hảo qua gốc tọa độ, vì vậy nếu $Z$ tuân theo $\mathcal{N}(0,1)$ thì $-Z$ cũng tuân theo $\mathcal{N}(0,1)$. Ý tưởng của Antithetic Variates rất đơn giản: mỗi khi sinh một số ngẫu nhiên $z_i$, đồng thời tạo ra luôn một số phụ $-z_i$, giúp triệt tiêu sai số lẫn nhau một cách tự nhiên [1].
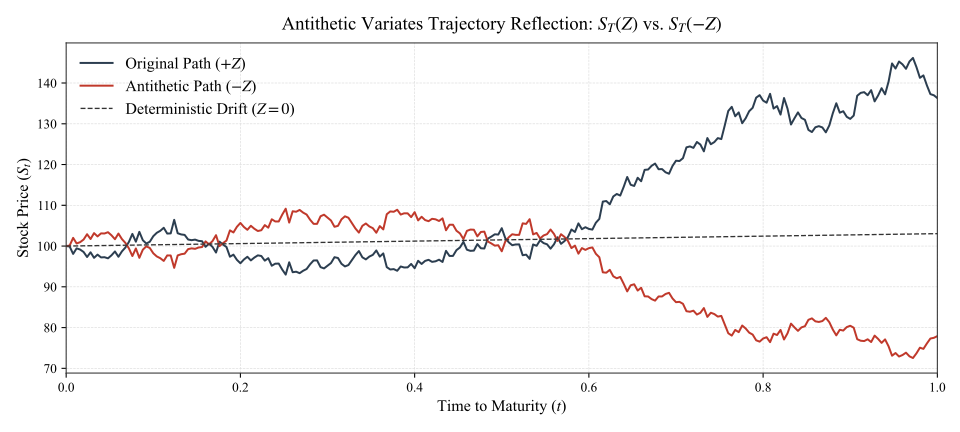
Với mỗi cặp $(z_i, -z_i)$, ta mô phỏng được hai đường giá đối xứng nhau. Nếu $z_i > 0$ đại diện cho một cú sốc tăng giá, thì $-z_i$ đại diện cho cú sốc giảm giá với cùng độ lớn. Ta tính payoff cho cả hai đường đi này, rồi lấy trung bình cộng của cặp làm một quan sát duy nhất [3]:
\[y_i = \frac{f(z_i) + f(-z_i)}{2} \tag{12.4}\]Nếu hàm payoff $f$ có xu hướng đơn điệu theo $Z$, thì khi $f(Z)$ lớn, $f(-Z)$ thường nhỏ, và ngược lại. Hai giá trị này có xu hướng bù trừ cho nhau, khiến trung bình của cặp ổn định hơn so với việc lấy hai mẫu hoàn toàn độc lập. Sự ổn định này giúp phương sai được giảm đi [1].
Lưu ý: về ký hiệu toán học $Z$ và $z$ cho bạn đọc mới làm quen với xác suất thống kê.
- $Z$ (chữ hoa): Là biến ngẫu nhiên (random variable) đại diện cho quy luật phân phối xác suất. Ví dụ $Z \sim \mathcal{N}(0,1)$ có nghĩa là $Z$ tuân theo phân phối chuẩn tắc với giá trị trung bình 0 và phương sai 1.
- $z$ (chữ thường): Là giá trị cụ thể (realization / sample) thu được từ quá trình sinh số ngẫu nhiên. Ví dụ lấy mẫu từ $\mathcal{N}(0,1)$ ta được các giá trị \(z = \{-0.50, 0.20, -1.00, 0.80, 0.30\}\).
2.2. Cơ sở toán học: Tại sao phương sai lại giảm?
Giả sử ta có thể thực hiện $n$ lần tính payoff, có hai cách như sau:
Standard Monte Carlo
Sinh $n$ số ngẫu nhiên độc lập \(\{z_1, \ldots, z_n\}\), tính trung bình cộng $n$ giá trị payoff $f(z_i)$. Gọi $Var[f(Z)] = \sigma_f^2$, phương sai của ước lượng là (suy luận tương tự như công thức (10.5)):
\[Var[\hat{V}_{std}] = \frac{\sigma_f^2}{n} \tag{12.5}\]Antithetic Variates
Sinh $n/2$ số ngẫu nhiên độc lập \(\{z_1, \ldots, z_{n/2}\}\), với mỗi $z_i$ ta tính cả $f(z_i)$ và $f(-z_i)$, rồi lấy trung bình $n/2$ cặp theo công thức (12.4). Vì $Z$ có cùng phân phối với $-Z$, ta có $Var[f(Z)] = Var[f(-Z)] = \sigma_f^2$. Phương sai của mỗi cặp là:
\[\begin{aligned} Var[Y] &= \frac{1}{4}\Big(Var[f(Z)] + Var[f(-Z)] + 2\, Cov[f(Z), f(-Z)]\Big) \\ &= \frac{2\sigma_f^2 + 2\,Cov[f(Z), f(-Z)]}{4} \\ &= \frac{\sigma_f^2 + Cov[f(Z), f(-Z)]}{2} \end{aligned} \tag{12.6}\]Vì $Y$ là trung bình của $n/2$ cặp độc lập, phương sai của ước lượng cuối cùng là:
\[Var[\hat{V}_{av}] = \frac{Var[Y]}{n/2} = \frac{\sigma_f^2 + Cov[f(Z), f(-Z)]}{n} \tag{12.7}\]So sánh (12.5) và (12.7), với cùng khối lượng tính toán, ta thấy ngay điều kiện để Antithetic Variates thắng thế như sau:
\[Var[\hat{V}_{av}] < Var[\hat{V}_{std}] \iff Cov[f(Z), f(-Z)] < 0 \tag{12.8}\]Điều kiện này được thỏa mãn khi $f$ là hàm đơn điệu (monotonic), đồng biến hoặc nghịch biến theo $Z$. Ví dụ trường hợp của European Call, vì $S_T$ là hàm tăng theo $Z$, và payoff $\max(S_T - K, 0)$ là hàm tăng theo $S_T$. Khi $Z$ lớn (giá tăng mạnh), $-Z$ nhỏ (giá giảm mạnh), khiến $f(Z)$ và $f(-Z)$ có xu hướng di chuyển ngược chiều nhau, tạo ra hiệp phương sai âm.
💬 Quant Interview Question 12.2: Antithetic Variates có luôn làm giảm phương sai không? Hãy cho một ví dụ mà kỹ thuật này không giúp ích gì, thậm chí có thể làm tình hình tệ hơn.
🗨️ Answer: Không, Antithetic Variates chỉ hiệu quả khi $Cov[f(Z), f(-Z)] < 0$.
Nếu $f$ là một hàm chẵn theo $Z$ (tức $f(Z) = f(-Z)$ với mọi $Z$), thì hai giá trị trong mỗi cặp luôn giống hệt nhau. Khi đó $Cov[f(Z), f(-Z)] = Var[f(Z)] = \sigma_f^2 > 0$ (tương quan hoàn hảo, dương), và theo công thức: $$Var[\hat{V}_{av}] = \frac{\sigma_f^2 + \sigma_f^2}{n} = \frac{2\sigma_f^2}{n}$$ Đây là con số gấp đôi phương sai của Standard MC với cùng số lượng mô phỏng $n$. Lý do là mỗi cặp chỉ cho ra đúng số lượng tin vì $f(Z) = f(-Z)$, nhưng ta lại tốn gấp đôi công sức tính toán cho thông tin đó.
Ví dụ cụ thể trong tài chính là một straddle đối xứng qua $S_0$, một sản phẩm phái sinh với payoff phụ thuộc vào độ lớn biến động chứ không phải hướng biến động. Với sản phẩm này, tăng mạnh hay giảm mạnh đều cho cùng một payoff, khiến $f$ gần như là hàm chẵn theo $Z$, và Antithetic Variates có thể làm tình hình tệ hơn.
Bài học rút ra là hãy luôn kiểm tra tính đơn điệu của hàm payoff trước khi áp dụng Antithetic Variates. Với hầu hết các quyền chọn Vanilla (European) và nhiều loại Path-dependent Option (Asian, Lookback), kỹ thuật này hoạt động rất tốt vì các hàm payoff phụ thuộc vào hướng biến động giá.
2.3. Thực hành Python
Ta tiếp tục thử định giá quyền chọn ATM Call với bộ tham số ở trên.
Hàm european_mc_av chỉ sinh $n/2$ số ngẫu nhiên, tính payoff cho cả hai nhánh payoff_pos và payoff_neg, rồi lấy trung bình từng cặp pair_avg = (payoff_pos + payoff_neg) / 2:
def european_mc_av(S, K, T, r, sigma, n_sim, option_type='call', seed=32):
    np.random.seed(seed)
    sign = 1 if option_type == 'call' else -1
    n_pairs = n_sim // 2

    Z = np.random.standard_normal(n_pairs)
    S_T_pos = S * np.exp((r - 0.5 * sigma**2) * T + sigma * np.sqrt(T) * Z)
    S_T_neg = S * np.exp((r - 0.5 * sigma**2) * T + sigma * np.sqrt(T) * (-Z))

    payoff_pos = np.maximum(sign * (S_T_pos - K), 0)
    payoff_neg = np.maximum(sign * (S_T_neg - K), 0)
    pair_avg = (payoff_pos + payoff_neg) / 2 # pair payoff, formula (12.4)

    price = np.exp(-r * T) * pair_avg.mean()
    se = np.exp(-r * T) * pair_avg.std(ddof=1) / np.sqrt(n_pairs)
    return price, se
Chú ý rằng n_sim ở đây đại diện cho tổng số lần tính payoff, bằng đúng khối lượng tính toán của Standard MC, trong khi số ngẫu nhiên cần sinh chỉ là n_pairs = n_sim // 2.
# Parameters
S, K, T, r, sigma, n_sim = 100.0, 100.0, 1.0, 0.05, 0.20, 10000

# Pricing
bs_price = black_scholes(S, K, T, r, sigma, 'call')
price_std, se_std = european_mc(S, K, T, r, sigma, n_sim, 'call')
price_av, se_av = european_mc_av(S, K, T, r, sigma, n_sim, 'call')
Black-Scholes             : 10.4506
Standard MC   (n = 10000) : 10.6350 ± 0.2906
Antithetic MC (n = 10000) : 10.6097 ± 0.2056
Variance reduction factor : 2.00x
Kết quả cho thấy:
- Cùng khối lượng tính toán, Antithetic Variates cho ra khoảng tin cậy nhỏ hơn hẳn (0.2056 so với 0.2906), tương đương phương sai giảm khoảng 2 lần.
- Giá Antithetic Variates (10.4552) cũng sát giá Black-Scholes (10.6097) hơn Standard MC (10.6350) trong lần chạy này, dù một phần là do yếu tố ngẫu nhiên, nhìn chung Antithetic Variates vẫn cho kết quả ổn định hơn qua các lần chạy.
Ưu điểm nổi bật của Antithetic Variates là:
- Phương pháp này giúp trung bình thực nghiệm của các biến ngẫu nhiên được sinh ra bằng đúng 0 một cách tuyệt đối [2].
- Tiết kiệm một nửa số lượng số ngẫu nhiên cần sinh ra. Với các bài toán mà việc sinh số ngẫu nhiên là điểm nghẽn hiệu năng, đây là một lợi ích đáng kể.
- Có thể mở rộng rất tự nhiên sang Path-dependent Option. Thay vì chỉ lật dấu một số ngẫu nhiên $Z$ duy nhất, ta lật dấu toàn bộ ma trận $Z$ để thu được hai đường đi giá đối xứng nhau qua mọi bước thời gian. Cấu trúc code hầu như không đổi so với hàm
simulate_pathsđã xây dựng, chỉ cần thêm một dòngpaths_av = simulate_paths(..., Z=-Z).
Bạn có thể tự tay điều chỉnh Widget để so sánh tốc độ hội tụ giữa Standard MC và Antithetic Variates.
- Đường Standard MC (đường mờ) dao động lên xuống khá mạnh khi $n$ còn nhỏ, trong khi đường Antithetic Variates (đường đậm) bám sát đường nét đứt ngay từ sớm. Đây chính là hình ảnh trực quan của việc giảm phương sai.
- Kéo Nb of simulations (n) từ thấp lên cao: cả hai đường đều hội tụ về Black-Scholes, nhưng để ý đường Antithetic Variates ổn định nhanh hơn nhiều, không cần đợi $n$ quá lớn.
- Kéo Resimulate nhiều lần ở cùng một mức $n$: đường Standard MC nhảy nhót khá thất thường giữa các lần chạy, còn đường Antithetic Variates dao động ít hơn vì mỗi cặp $(Z,-Z)$ đã “tự cân bằng” một phần nhiễu ngay bên trong.
- Nhìn vào bảng metrics phía dưới: so sánh trực tiếp $SE$ của hai phương pháp và hệ số Variance Reduction, con số này thường dao động quanh 2–4x tùy tham số.
3. Control Variates: Hiệu chỉnh bằng biến kiểm soát
3.1. Ý tưởng: Neo vào một giá trị lý thuyết đã biết
Cả Moment Matching và Antithetic Variates đều nỗ lực giảm phương sai bằng cách tập trung vào thuộc tính nội tại của biến chuẩn tắc $Z$. Tuy nhiên, nếu hàm payoff mang tính phi tuyến cao, hiệu quả triệt tiêu sẽ bị giảm đáng kể. Control Variates lại tiếp cận bài toán theo một triết lý hoàn toàn khác. Phương pháp này giữ nguyên toàn bộ kịch bản mô phỏng gốc, nhưng sử dụng sai số từ việc ước lượng một sản phẩm tài chính khác nhưng đã biết công thức giải tích chính xác để điều chỉnh cho sản phẩm phức tạp cần định giá [1].
Ý tưởng rất đời thường: giả sử bạn muốn cân một vật rất nhẹ, bằng một chiếc cân cũ kém chính xác. Nếu bạn có sẵn một quả cân chuẩn 1kg, bạn có thể đặt cả vật cần cân và quả cân chuẩn lên cân cùng lúc, biết chính xác sai số của cân tại điểm 1kg, rồi dùng sai số đó để hiệu chỉnh lại kết quả đo vật nhẹ. Nếu chiếc cân có xu hướng sai lệch theo cùng một kiểu tại mọi mức cân, việc hiệu chỉnh này sẽ giúp bạn đo vật nhẹ chính xác hơn nhiều so với việc cân nó một mình.
Quay lại bài toán Monte Carlo, “vật cần cân” là biến ngẫu nhiên $X$ mà ta muốn ước lượng $\mathbb{E}[X]$ (ví dụ như payoff của một quyền chọn khó định giá), còn “quả cân chuẩn” là một biến ngẫu nhiên $Y$ có liên hệ chặt chẽ với $X$ (ví dụ được sinh ra từ cùng những kịch bản mô phỏng), mà ta đã biết chính xác $\mathbb{E}[Y] = \mu_Y$ nhờ công thức đóng nào đó.
Cho $c$ là một hằng số tự chọn, ước lượng Control Variates được định nghĩa như sau [1]:
\[\hat{X}_{cv} = X - c\,(Y - \mu_Y) \tag{12.9}\]Vì $\mathbb{E}[Y] = \mu_Y$, số hạng $(Y - \mu_Y)$ có kỳ vọng bằng $0$, nên với bất kỳ giá trị $c$ nào, ước lượng $\hat{X}_{cv}$ vẫn là ước lượng không chệch (unbiased) của $\mathbb{E}[X]$:
\[\mathbb{E}[\hat{X}_{cv}] = \mathbb{E}[X] - c\,(\mathbb{E}[Y] - \mu_Y) = \mathbb{E}[X] \tag{12.10}\]Nếu mô phỏng đánh giá quá cao giá trị của $Y$ ($Y > \mu_Y$), thì do tính tương đồng, nó cũng sẽ đánh giá quá cao giá trị của $X$. Hiệu số sai lệch $-c(Y-\mu_Y)$ sẽ được dùng làm “thước đo lỗi” để bù trừ và hiệu chỉnh trực tiếp cho $X$, giúp giảm thiểu đáng kể phương sai của kết quả định giá cuối cùng.
3.2. Cơ sở toán học: Hệ số tối ưu và mức giảm phương sai
Phương sai của ước lượng $\hat{X}_{cv}$ là:
\[Var[\hat{X}_{cv}] = Var[X] - 2c\,Cov[X,Y] + c^2\,Var[Y] \tag{12.11}\]Vì hệ số của $c^2$ là $\text{Var}[Y] > 0$, hàm phương sai theo $c$ là một hàm bậc hai lồi (parabol) (Hình 3). Do đó, hàm này tồn tại một điểm đáy \(c^*\) duy nhất, chính là giá trị giúp tối thiểu hóa phương sai. Lấy đạo hàm theo $c$ và cho bằng 0 để tìm cực trị:
\[\begin{aligned} \frac{d}{dc}Var[\hat{X}_{cv}] &= -2\,Cov[X,Y] + 2c\,Var[Y] = 0 \\ \implies c^* &= \frac{Cov[X,Y]}{Var[Y]} \end{aligned} \tag{12.12}\]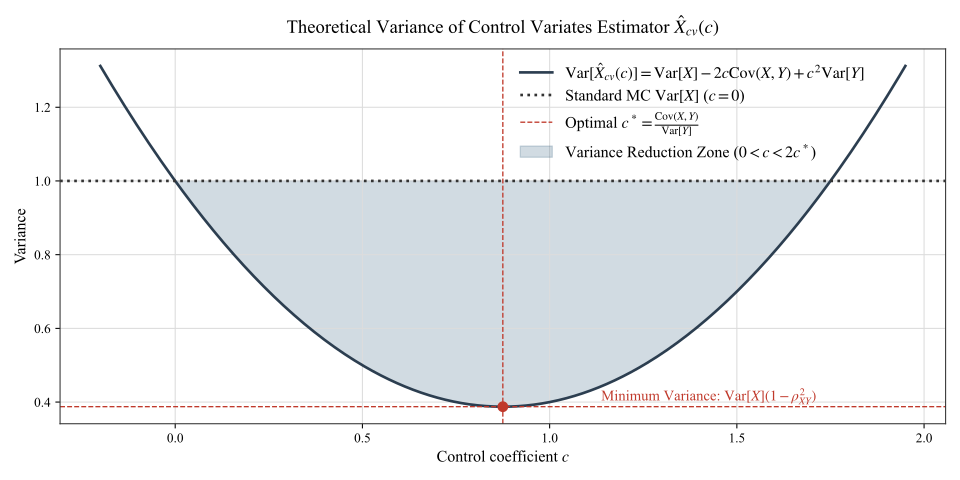
Thay $c^*$ trở lại công thức (12.10), ta được phương sai tối thiểu:
\[Var[\hat{X}_{cv}]_{\min} = Var[X]\left(1 - \rho_{X,Y}^2\right), \qquad \rho_{X,Y} = \frac{Cov[X,Y]}{\sqrt{Var[X]\,Var[Y]}} \tag{12.13}\]Công thức (12.13) cho thấy mức giảm phương sai phụ thuộc duy nhất vào hệ số tương quan $\rho_{X,Y}$ giữa biến cần ước lượng và biến kiểm soát.
- Nếu $\rho \to \pm 1$, phương sai gần như bị triệt tiêu hoàn toàn.
- Nếu $\rho = 0$, không có ích nhưng cũng không hại gì, vì khi đó \(Cov[X,Y]=0 \Rightarrow c^*=0\), đưa ước lượng trở về đúng Standard MC.
💬 Quant Interview Question 12.3: Nếu $X$ và $Y$ không tương quan ($\rho = 0$), nhưng chọn $c = 1$ thay vì $c^* = 0$, điều gì sẽ xảy ra?
🗨️ Answer: Ước lượng vẫn không chệch (vì *tính không chệch* đúng với mọi $c$, không riêng $c^*$), nhưng phương sai sẽ tăng lên thay vì giảm. Thay $\rho=0$ và với $c=1$ vào công thức, ta có:
$$Var[\hat{X}_{cv}] = Var[X] + Var[Y]$$ lớn hơn hẳn $Var[X]$ ban đầu. Ta đã vô tình cộng thêm phương sai của $Y$ vào ước lượng mà không nhận được lợi ích hiệu chỉnh nào, vì $Y$ không hề mang thông tin gì về sai lệch của $X$. Đây là lý do vì sao trong thực hành, ta luôn ước lượng $c^*$ từ chính dữ liệu mẫu (hiệp phương sai và phương sai mẫu) thay vì chọn $c=1$ một cách chủ quan.
Vấn đề quan trọng nhất khi áp dụng kỹ thuật này là: tìm đâu ra một biến $Y$ vừa tương quan cao với $X$, vừa có công thức đóng cho $\mathbb{E}[Y]$? Đây chính là lúc kiến thức về các mô hình định giá khác nhau mà ta đã tích lũy qua các bài trước phát huy tác dụng.
3.3. Ứng dụng: European Option làm Control Variates
Nhớ lại từ Bài 11, quyền chọn kiểu giá trung bình (Arithmetic Asian Option) không có công thức đóng, vì tổng của nhiều biến log-chuẩn tương quan với nhau không còn tuân theo phân phối log-chuẩn nữa.
Ta cần tìm một biến kiểm soát $Y$ nào đó, sinh ra từ cùng đường đi giá với $X$ (payoff của Arithmetic Asian Option), nhưng có công thức đóng. Lựa chọn tốt nhất là Geometric Asian Option, nhưng đòi hỏi một công thức đóng riêng, khá phức tạp, theo Kemna & Vorst, 1990 [6]. Một lựa chọn khác không tốt bằng, nhưng đơn giản hơn nhiều chính là European Option, với công thức Black-Scholes quen thuộc.
Để ví dụ trực quan dễ hiểu hơn, tôi chọn European Option, một biến kiểm soát thỏa mãn các điều kiện của bài toán.
- Asian Call có payoff $X = \max(\bar{S} - K, 0)$, phụ thuộc vào trung bình toàn bộ đường đi của giá, ký hiệu $\bar{S}$.
- European Call có payoff $Y = \max(S_T - K, 0)$, chỉ phụ thuộc vào điểm cuối đường đi giá, với kỳ vọng được tính chính xác bằng \(\mu_Y = C_{BS} = S_0 N(d_1) - K e^{-rT} N(d_2)\)
- $\bar{S}$ liên hệ chặt chẽ với $S_T$ vì đến từ cùng một đường đi của giá. Hơn nữa, khi giá cổ phiếu có xu hướng tăng mạnh trong suốt kỳ hạn, cả trung bình và điểm cuối đều có xu hướng tăng theo, giúp $X$ và $Y$ có tương quan dương.
Ví dụ: Hãy dùng lại đúng 5 quỹ đạo giá đã mô phỏng ở Bài 11 (Bảng 4), với $S_0=100$, $K=100$, $T=1$, $r=5\%$, $\sigma=20\%$. Ta chỉ cần lấy lại đúng cột giá đáo hạn $S_T$ đã có sẵn trong bảng gốc, không cần tính gì thêm.
| Path | $\bar{S}$ (average) | $X$ (Asian payoff) | $S_T$ (expiry) | $Y$ (European payoff) |
|---|---|---|---|---|
| 1 | $108.72$ | $8.72$ | $108.33$ | $8.33$ |
| 2 | $95.17$ | $0.00$ | $94.83$ | $0.00$ |
| 3 | $103.98$ | $3.98$ | $106.34$ | $6.34$ |
| 4 | $91.37$ | $0.00$ | $85.22$ | $0.00$ |
| 5 | $103.36$ | $3.36$ | $108.74$ | $8.74$ |
Hai cột payoff bám theo nhau khá rõ (path 2 và 4 đều bằng 0 ở cả hai, path 1 và 5 đều lớn ở cả hai), nhưng không song hành tuyệt đối như khi dùng Geometric Asian Option, vì $S_T$ có thể lệch khá xa so với $\bar{S}$ trên một quỹ đạo giá cụ thể.
Từ 5 cặp $(x_i, y_i)$ ở bảng trên, tính hiệp phương sai, phương sai mẫu và hệ số tương quan $\rho \approx 0.83$. Theo công thức (12.12), ta có $c^* \approx 0.6815$. Với $\mu_Y \approx 10.4506$, áp dụng công thức (12.9) cho từng quỹ đạo, ta được bảng sau:
| Path | $X$ | $Y$ | $\hat{X}_{cv} = X - c^*(Y - \mu_Y)$ |
|---|---|---|---|
| 1 | $8.72$ | $8.33$ | $10.17$ |
| 2 | $0.00$ | $0.00$ | $7.12$ |
| 3 | $3.98$ | $6.34$ | $6.78$ |
| 4 | $0.00$ | $0.00$ | $7.12$ |
| 5 | $3.36$ | $8.74$ | $4.53$ |
Giá ước lượng bằng Control Variates (chỉ với 5 kịch bản):
\[e^{-0.05 \times 1} \times \frac{10.17 + 7.12 + 6.78 + 7.12 + 4.53}{5} \approx 0.9512 \times 7.14 \approx \mathbf{6.79}\]Phương sai mẫu giảm từ $Var(X) \approx 12.90$ xuống $Var(\hat{X}_{cv}) \approx 4.03$, tức giảm khoảng 3 lần. Con số này khiêm tốn hơn nhiều so với mức giảm gần như tuyệt đối nếu dùng Geometric Asian Option, nhưng đổi lại, ta không cần học thêm bất kỳ công thức định giá mới nào, chỉ cần công thức Black-Scholes đã biết từ lâu.
Bạn có thể tự tay điều chỉnh Widget này để cảm nhận rõ hơn về mối quan hệ giữa hai biến $X$ và $Y$:
- Mỗi chấm trên biểu đồ là một cặp payoff $(x_i, y_i)$ từ một kịch bản mô phỏng, càng gần đường nét đứt (đường hồi quy), tương quan càng cao.
- Kéo Volatility (σ) từ thấp lên cao: quan sát $\rho$ giảm dần. Biến động càng mạnh, giá trung bình $\bar{S}$ và giá cuối $S_T$ càng có xu hướng “tách nhau” ra trên từng quỹ đạo cụ thể.
- Kéo Nb of simulations (n) lên mức cao (> 500): đường hồi quy ổn định hơn hẳn, và khoảng tin cậy của cả hai ước lượng (Standard MC / Control Variates) đều thu hẹp lại.
- Cuối cùng, kéo Resimulate vài lần ở $n$ thấp: bạn sẽ thấy \(c^*\) và hệ số variance reduction dao động khá mạnh giữa các lần chạy, minh chứng cho việc \(c^*\) ước lượng từ mẫu nhỏ vẫn còn nhiễu, cần $n$ đủ lớn mới ổn định.
3.4. Thực hành Python
Điểm hay của việc chọn European Option làm biến kiểm soát là ta không cần viết thêm hàm định giá mới, chỉ cần hàm black_scholes quen thuộc từ Bài 7.
Hàm asian_mc_cv chi tiết như sau:
- Tái sử dụng
simulate_pathstừ Bài 10 / Bài 11 - Tính payoff Arithmetic Asian ($X$) dựa trên giá trung bình
paths[:, 1:].mean(axis=1) - Tính payoff European ($Y$) dựa trên giá cuối cùng
paths[:, -1] - Áp dụng công thức Control Variates (12.9) với hệ số $c^*$ (12.12) ước lượng trực tiếp từ dữ liệu mẫu bằng
np.cov():
def asian_mc_cv(S, K, T, r, sigma, n_step, n_sim, option_type='call'):
    paths = simulate_paths(S, T, r, sigma, n_step, n_sim)
    sign = 1 if option_type == 'call' else -1

    S_arith = paths[:, 1:].mean(axis=1)
    S_T = paths[:, -1]
    X = np.exp(-r * T) * np.maximum(sign * (S_arith - K), 0) # payoff Arithmetic Asian
    Y = np.exp(-r * T) * np.maximum(sign * (S_T - K), 0) # payoff European

    mu_Y = black_scholes(S, K, T, r, sigma, option_type)
    c_star = np.cov(X, Y, ddof=1)[0, 1] / np.var(Y, ddof=1) # formula (12.12)
    X_cv = X - c_star * (Y - mu_Y) # formula (12.9)

    price = X_cv.mean()
    se = X_cv.std(ddof=1) / np.sqrt(n_sim)
    return price, se, c_star
Ta thử định giá lại đúng Average Price Asian Call đã định giá bằng Standard MC ở Bài 11 (S=100, K=100, T=1, r=5%, σ=20%, n_step=252, n_sim=10000). Tôi thêm vào cả kết quả từ hàm asian_mc_cv_geo dùng Geometric Asian Option làm biến kiểm soát để bạn đọc có thể so sánh.
# Parameters
S, K, T, r, sigma, n_sim = 100.0, 100.0, 1.0, 0.05, 0.20, 10000
n_step = 252

# Pricing
price_naive, se_naive = asian_mc(S, K, T, r, sigma, n_step, n_sim, 'call')
price_cv, se_cv, c_star = asian_mc_cv(S, K, T, r, sigma, n_step, n_sim, 'call')
price_cv_geo, se_cv_geo, c_star_geo = asian_mc_cv_geo(S, K, T, r, sigma, n_step, n_sim, 'call')
Standard MC     (n= 10000)             : 5.6898 ± 0.1560
Control Variate, European (n= 10000)   : 5.7599 ± 0.0853   (c*=0.4552)
Variance reduction factor, European    : 3.34x
Control Variate, Geo Asian (n= 10000)  : 5.7805 ± 0.0043   (c*=1.0353)
Variance reduction factor, Geo Asian   : 1291.69x
Kết quả cho thấy rõ sức mạnh của Control Variates trong bài toán này:
- Cả Standard MC và Control Variates đều hội tụ về cùng một vùng giá trị, xác nhận tính không chệch của cả hai ước lượng.
- Với European Option làm biến kiểm soát, phương sai giảm khoảng hơn 3 lần, khá tương đồng với kết quả từ phần tính toán thủ công.
- Với Geometric Asian Option làm biến kiểm soát, phương sai giảm tới 1290 lần. Hệ số $c^* \approx 1.0353$ rất gần $1$, phản ánh đúng lý thuyết khi Geometric và Arithmetic cho payoff có tương quan cực kỳ chặt chẽ với nhau.
So với Antithetic Variates (chỉ hiệu quả với payoff đơn điệu), Control Variates có một lợi thế đặc biệt: mức giảm phương sai của nó có thể được đo lường và tối ưu hóa tự động ngay trong lúc chạy mô phỏng. Thông qua công thức \(c^*\) ước lượng từ chính dữ liệu, code sẽ tự tìm ra \(c^*\) tốt nhất có thể với bất kỳ biến kiểm soát nào đưa vào.
Bài học thực tiễn của Control Variates là: biến kiểm soát không cần hoàn hảo mới có ích, miễn là $\rho \neq 0$. Hãy bắt đầu với biến kiểm soát đơn giản nhất mà bạn đã có sẵn công thức đóng như European Option. Với những ai muốn giảm phương sai thêm nữa và sẵn sàng đánh đổi bằng một công thức phức tạp hơn, Geometric Asian Option (Kemna & Vorst, 1990 [6]; Vorst, 1992 [7]) vẫn là lựa chọn đáng tham khảo.
4. Tóm tắt và thảo luận
Ba kỹ thuật Moment Matching, Antithetic Variates, và Control Variates mang lại hiệu quả giảm phương sai rõ rệt nhờ tận dụng tính chất đại số và mối tương quan sẵn có. Tuy nhiên, chúng có một điểm chung: vẫn phụ thuộc hoàn toàn vào cơ chế lấy mẫu ngẫu nhiên truyền thống. Khi bước sang các bài toán phức tạp hơn: quyền chọn Deep OTM (nơi hầu hết các kịch bản mô phỏng đều cho payoff bằng 0), hoặc các phái sinh nhiều chiều (Basket Option),… thì việc khớp lại mô-men hay tạo biến đối xứng chỉ còn mang lại hiệu quả rất nhỏ.
Để phá vỡ giới hạn này, ta cần những công cụ mạnh mẽ hơn: thay đổi trực tiếp cấu trúc không gian mẫu hoặc biến đổi hẳn phân phối xác suất gốc. Đó chính là nội dung ta sẽ cùng khám phá trong bài tiếp theo về Stratified Sampling, Importance Sampling và Quasi-Monte Carlo.
- Hull, J. C. (2021). Options, Futures, and Other Derivatives (11th ed.). Pearson.
- Joshi, M. S. (2003). The Concepts and Practice of Mathematical Finance. Cambridge University Press.
- Haug, E. G. (2007). The Complete Guide to Option Pricing Formulas (2nd ed.). McGraw-Hill.
- Boyle, P. P. (1977). Options: A Monte Carlo Approach. Journal of Financial Economics, 4(3), 323–338.
- Hammersley, J. M., & Morton, K. W. (1956). A New Monte Carlo Technique: Antithetic Variates. Mathematical Proceedings of the Cambridge Philosophical Society, 52(3), 449–475.
- Kemna, A. G. Z., & Vorst, A. C. F. (1990). A Pricing Method for Options Based on Average Asset Values. Journal of Banking & Finance, 14(1), 113–129.
- Vorst, T. (1992). Prices and Hedge Ratios of Average Exchange Rate Options. International Review of Financial Analysis, 1(3), 179–193.