Bài 13: Variance Reduction Techniques trong Monte Carlo Simulation (2/2)
Khám phá Stratified Sampling, Importance-Sampling, và Quasi-Monte Carlo, ba kỹ thuật nâng cao can thiệp sâu vào không gian và mật độ xác suất giúp giảm phương sai mà không cần tăng số lượng mô phỏng. Ví dụ định giá deep OTM Call kèm code Python chi tiết.
Ở bài trước, chúng ta đã làm quen với ba kỹ thuật giảm phương sai đầu tiên, tập trung khai thác tính đối xứng và tương quan tuyến tính. Nhưng chuyện gì sẽ xảy ra nếu ta cần định giá một hợp đồng deep OTM, hay một Path-dependent Option phức tạp nhiều chiều. Bài viết này sẽ giới thiệu một cấp độ cao hơn của giảm phương sai: can thiệp vào không gian và mật độ xác suất.
Trong bài viết này, chúng ta sẽ lần lượt khám phá 3 kỹ thuật còn lại: Stratified Sampling, Importance Sampling, và Quasi-Monte Carlo.
Trong bài viết này:
- 1. Stratified Sampling: Lấy mẫu phân tầng
- 2. Importance Sampling: Lấy mẫu đúng nơi cần lấy
- 3. Quasi-Monte Carlo: Khi “ngẫu nhiên” không còn là lựa chọn tốt nhất
1. Stratified Sampling: Lấy mẫu phân tầng
1.1. Ý tưởng: Từ khảo sát dân số đến lấy mẫu Monte Carlo
Hãy tưởng tượng bạn cần khảo sát mức lương trung bình của người lao động Việt Nam bằng cách phỏng vấn 1000 người. Nếu bạn lấy mẫu hoàn toàn ngẫu nhiên, có một rủi ro là: bạn vô tình phỏng vấn quá nhiều người ở thành phố lớn (nơi lương cao) và quá ít người ở các tỉnh miền núi (nơi lương thấp), khiến kết quả khảo sát bị lệch dù về mặt lý thuyết cách lấy mẫu là hoàn toàn công bằng.
Cách khắc phục kinh điển trong thống kê là Stratified Sampling (SS) hay lấy mẫu phân tầng. Bạn chia dân số thành các tầng (strata) – theo tỉnh/thành, theo độ tuổi, hay theo ngành nghề – rồi chủ động đảm bảo mỗi tầng được đại diện đúng theo tỷ lệ dân số trong mẫu khảo sát tổng, thay vì phó mặc hoàn toàn cho ngẫu nhiên. Nếu miền núi chiếm 10% dân số, bạn ép mẫu của mình có đúng 10% người được phỏng vấn đến từ miền núi.
Áp dụng ý tưởng này vào Monte Carlo: thay vì lấy ngẫu nhiên các điểm mẫu dễ dẫn đến hiện tượng co cụm ở một số vùng, ta chia phân phối xác suất cần mô phỏng thành $K$ tầng có xác suất bằng nhau, mỗi tầng chiếm đúng $1/K$ khối lượng xác suất, rồi ép đúng $n/K$ mẫu rơi vào mỗi tầng. Không tầng nào bị bỏ quên, không tầng nào bị quá tải, bất kể may rủi của lần lấy mẫu cụ thể đó. Tại mỗi tầng này, ta chỉ chọn ra duy nhất một giá trị đại diện, thường là giá trị trung bình của tầng đó [1].
1.2. Cơ sở toán học: Phân rã phương sai theo tầng
Trong mô phỏng Monte Carlo, để tạo ra các biến ngẫu nhiên $Z$ tuân theo phân phối chuẩn tắc $\mathcal{N}(0,1)$, quy trình cơ bản luôn bắt đầu bằng việc sinh các số ngẫu nhiên độc lập phân phối đều $U \sim \mathcal{U}(0,1)$, sau đó ánh xạ sang $Z$. Dựa trên hàm phân phối tích lũy chuẩn tắc $N(x)$, ta tìm biến $Z$ thông qua hàm nghịch đảo $N^{-1}$ [1]:
\[Z = N^{-1}(U), \qquad U \sim \mathcal{U}(0,1) \tag{13.1}\]Để tạo ra mẫu phân tầng, ta chia khoảng $[0,1)$ thành $K$ khoảng con bằng nhau, và trong khoảng con thứ $k$ với \(k = \{0, 1, \ldots, K-1\}\), ta sinh:
\[u_i^{(k)} = \frac{k + v_i}{K}, \qquad v_i \sim \mathcal{U}(0,1), \qquad z_i^{(k)} = N^{-1}\left(u_i^{(k)}\right) \tag{13.2}\]Vì $u_i^{(k)}$ luôn nằm trong khoảng $[k/K, (k+1)/K)$, tương ứng với đúng $1/K$ khối lượng xác suất của $\mathcal{N}(0,1)$, nên $n/K$ mẫu sinh ra từ mỗi tầng $k$ luôn luôn đại diện đúng cho tầng đó, không phụ thuộc vào may rủi.
Bây giờ, hãy phân tích tại sao cách này luôn làm giảm phương sai. Gọi $\mu_k$ và $\sigma_k^2$ lần lượt là kỳ vọng và phương sai của payoff $f(Z^{(k)})$ với $Z^{(k)}$ thuộc tầng $k$, và $\mu = \mathbb{E}[f(Z)]$ là kỳ vọng trên toàn bộ mẫu. Vì $K$ tầng có xác suất bằng nhau, $1/K$ mỗi tầng, Định luật phương sai toàn phần cho ta [4]:
\[Var[f(Z)] = \underbrace{\frac{1}{K}\sum_{k=0}^{K-1} \sigma_k^2}_{\text{within-stratum}} + \underbrace{\frac{1}{K}\sum_{k=0}^{K-1} (\mu_k - \mu)^2}_{\text{between-stratum}} \tag{13.3}\]Standard MC với $n$ mẫu độc lập phải gánh cả hai thành phần. Vì với cách chọn thông thường, có lần tầng $k$ nhận được quá nhiều mẫu, có lần lại quá ít mẫu. Chính sự dao động ngẫu nhiên của tỷ lệ mẫu xung quanh giá trị lý thuyết $1/K$ tạo ra thành phần phương sai giữa các tầng.
\[Var[\hat{V}_{std}] = \frac{Var[f(Z)]}{n} = \frac{1}{n} \left[ \underbrace{\frac{1}{K}\sum_{k=0}^{K-1} \sigma_k^2}_{\text{within-stratum}} + \underbrace{\frac{1}{K}\sum_{k=0}^{K-1} (\mu_k - \mu)^2}_{\text{between-stratum}} \right] \tag{13.4}\]Nhưng Stratified Sampling với $n/K$ mẫu mỗi tầng chỉ còn phải gánh thành phần trong tầng (within-stratum), vì thành phần giữa các tầng (between-stratum) đã được loại bỏ hoàn toàn, do mỗi tầng luôn đóng góp đúng $1/K$ trọng số vào ước lượng cuối cùng, không còn dao động ngẫu nhiên nữa.
\[Var[\hat{V}_{ss}] = \frac{1}{n} \left[ \underbrace{\frac{1}{K}\sum_{k=0}^{K-1} \sigma_k^2}_{\text{within-stratum}} \right] = \frac{\overline{\sigma_k^2}}{n} \tag{13.5}\]So sánh (13.4) và (13.5), ta có một kết quả rất đẹp:
\[Var[\hat{V}_{std}] - Var[\hat{V}_{ss}] = \frac{1}{n} \left[ \frac{1}{K}\sum_{k=0}^{K-1}(\mu_k-\mu)^2 \right] \geq\; 0 \tag{13.6}\]Như vậy, Stratified Sampling không bao giờ tệ hơn Standard MC, chỉ có thể bằng hoặc tốt hơn. So với Antithetic Variates ở bài trước (có thể phản tác dụng với payoff dạng hàm chẵn), đây là một sự đảm bảo toán học chắc chắn, không có điều kiện ràng buộc nào.
💬 Quant Interview Question 13.1: Điều gì sẽ xảy ra với phương sai của Stratified Sampling nếu toàn bộ biến động của payoff nằm giữa các tầng, còn trong mỗi tầng, payoff gần như không đổi?
🗨️ Answer: Đây là trường hợp lý tưởng nhất cho kỹ thuật này. Nếu payoff gần như là hằng số trong mỗi tầng, thì $\sigma_k^2 \approx 0$ với mọi $k$, suy ra $Var[\hat{V}_{ss}] \approx 0$, một ước lượng gần như không có phương sai, dù bạn chỉ dùng một mẫu duy nhất cho mỗi tầng!
Điều này giải thích vì sao Stratified Sampling đặc biệt hiệu quả với các payoff gần như đơn điệu theo $Z$ như quyền chọn mua/bán kiểu Âu. Khi $Z$ càng lớn thì $S_T$ càng lớn theo một hàm mượt, nên trong một dải hẹp (một tầng) của $Z$, giá trị payoff dao động rất ít – gần như toàn bộ "thông tin bất định" thực ra nằm ở việc tầng nào ta đang ở, không phải ở việc ta ở vị trí nào trong tầng đó. Đây chính xác là lý do khiến $K$ càng lớn (tầng càng hẹp), phương sai càng giảm mạnh.
1.3. Thực hành thủ công: Stratified Sampling cho ATM Call
Hãy minh họa bằng một ví dụ định giá ATM European Call với $S_0=100$, $K=100$, $T=1$, $r=5\%$, $\sigma=20\%$, giá Black-Scholes tham chiếu là $C_{BS} \approx 10.4506$.
Chia phân phối $\mathcal{N}(0,1)$ thành $K=4$ tầng có xác suất bằng nhau (mỗi tầng 25% khối lượng xác suất). Để minh họa đơn giản nhất, ta lấy điểm giữa của mỗi tầng làm đại diện, cụ thể bốn giá trị $z$ kinh điển hay gặp trong bảng tra cứu phân vị (các chấm đỏ, Hình 1):
\[z^{(1)} = -1.150, \quad z^{(2)} = -0.319, \quad z^{(3)} = 0.319, \quad z^{(4)} = 1.150\]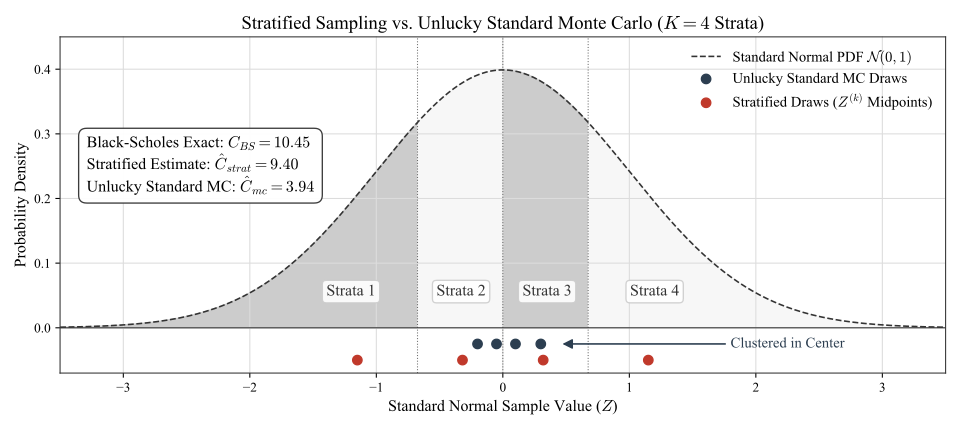
Ta tính toán các giá trị trung gian như sau:
- Xu hướng: $(r - \frac{1}{2}\sigma^2)T= (0.05 - 0.5 \times 0.2^2) \times 1 = 0.03$.
- Độ biến động: $\sigma\sqrt{T} = 0.2 \times \sqrt{1} = 0.2$.
| Strata $k$ | $Z^{(k)}$ | $S_T = S_0 e^{(r-\sigma^2/2)T + \sigma\sqrt{T}Z^{(k)}}$ | Payoff $max(S_T - K, 0)$ |
|---|---|---|---|
| 1 | $-1.150$ | $100 \times \exp(0.03 + 0.2 \times -1.150) = 81.87$ | $0.00$ |
| 2 | $-0.319$ | $100 \times \exp(0.03 + 0.2 \times -0.319) = 96.68$ | $0.00$ |
| 3 | $0.319$ | $100 \times \exp(0.03 + 0.2 \times 0.319) = 109.83$ | $9.83$ |
| 4 | $1.150$ | $100 \times \exp(0.03 + 0.2 \times 1.150) = 129.69$ | $29.69$ |
Giá ước lượng bằng Stratified Sampling (chỉ với 4 kịch bản):
\[e^{-0.05 \times 1} \times \frac{0 + 0 + 9.83 + 29.69}{5} \approx 0.9512 \times 9.88 \approx \mathbf{9.40}\]Để thấy rõ giá trị của việc phân tầng, hãy so sánh với một kịch bản hoàn toàn có thể xảy ra với Standard MC: giả sử chỉ có 4 mẫu và xui rủi đều rơi gần vùng trung tâm \(\{-0.20, 0.10, -0.05, 0.30\}\). Điều này hoàn toàn hợp lệ về mặt xác suất, chỉ là do vận rủi của lần lấy mẫu này:
| $Z$ | $S_T = S_0 e^{(r-\sigma^2/2)T + \sigma\sqrt{T}Z}$ | Payoff $max(S_T - K, 0)$ |
|---|---|---|
| $-0.20$ | $100 \times \exp(0.03 + 0.2 \times -0.20) = 99.00$ | $0.00$ |
| $0.10$ | $100 \times \exp(0.03 + 0.2 \times 0.10) = 105.13$ | $5.13$ |
| $-0.05$ | $100 \times \exp(0.03 + 0.2 \times -0.05) = 102.02$ | $2.02$ |
| $0.30$ | $100 \times \exp(0.03 + 0.2 \times 0.30) = 109.42$ | $9.42$ |
Giá ước lượng bằng Standard MC trong lần lấy mẫu này:
\[e^{-0.05 \times 1} \times \frac{0 + 5.13 + 2.02 + 9.42}{5} \approx 0.9512 \times 4.14 \approx \mathbf{3.94}\]Với cùng 4 mẫu, SS (9.40) bám sát giá trị thật hơn nhiều so với kịch bản không may mắn của Standard MC (3.94). Sự khác biệt không phải vì SS may mắn hơn, mà vì nó không cho phép kịch bản “xui” có thể xảy ra.
1.4. Thực hành Python
Bạn có thể chạy thử trên Google Colab.

Hàm european_mc_ss chi tiết như sau:
- Thực hiện phân $K$ tầng bằng nhau trên biến ngẫu nhiên đều $U$ theo công thức (13.2), rồi mới ánh xạ sang biến ngẫu nhiên chuẩn $Z$
Z = norm.ppf(U). - Mỗi tầng ta có
n_per = n_sim // n_stratamẫu, dùng để tínhS_Tvàpayoffsnhư bình thường. Tuy nhiên, chỉ một giá trị duy nhất đại diện cho toàn bộ tầng này, là giá trị trung bìnhstratum_means = payoffs.mean(axis=1). - Giá cuối cùng
priceđược tính từ giá trị trung bình trong từng tầngstratum_means, không phải từ trung bìnhpayoffsthô của toàn bộ mẫu.
def european_mc_ss(S, K, T, r, sigma, n_sim, n_strata, option_type='call', seed=32):
    np.random.seed(seed)
    sign = 1 if option_type == 'call' else -1
    n_per = n_sim // n_strata

    strata = np.arange(n_strata).reshape(-1, 1) # shape (K, 1)
    V = np.random.uniform(size=(n_strata, n_per))  # shape (K, n_per)
    U = (strata + V) / n_strata # formula (13.2)
    Z = norm.ppf(U)

    S_T = S * np.exp((r - 0.5 * sigma**2) * T + sigma * np.sqrt(T) * Z) # shape (K, n_per)
    payoffs = np.maximum(sign * (S_T - K), 0) # shape (K, n_per)

    stratum_means = payoffs.mean(axis=1) # shape (K, 1)
    stratum_vars = payoffs.var(axis=1, ddof=1) # shape (K, 1)

    price = np.exp(-r * T) * stratum_means.mean()
    se = np.exp(-r * T) * np.sqrt(stratum_vars.mean() / n_sim)
    return price, se
Ta so sánh với Standard MC, hàm european_mc, từ bài trước:
# Parameters
S, K, T, r, sigma, n_sim = 100.0, 100.0, 1.0, 0.05, 0.20, 10000
n_strata = 100

# Pricing
bs_price = black_scholes(S, K, T, r, sigma, 'call')
price_std, se_std = european_mc(S, K, T, r, sigma, n_sim, 'call')
price_strat, se_strat = european_mc_ss(S, K, T, r, sigma, n_sim, n_strata, 'call')
Black-Scholes                  : 10.4506
Standard MC   (n=10000)        : 10.6350 ± 0.2906
Stratified MC (n=10000, K=100) : 10.4535 ± 0.0243
Variance reduction factor      : 143x
Kết quả cho thấy rõ sức mạnh của việc phân tầng: chỉ với 100 tầng, phương sai giảm hơn 143 lần so với Standard MC dùng cùng số lượng mẫu, và giá ước lượng gần như trùng khớp với giá Black-Scholes. Điều này nhất quán với phân tích ở trên: vì payoff của European Call gần như đơn điệu theo $Z$, phần lớn phương sai tổng thể là phương sai giữa các tầng – đúng phần mà SS triệt tiêu hoàn toàn.
Bạn có thể tự tay điều chỉnh Widget 1 để xem Stratified Sampling hoạt động trong các điều kiện khác nhau. Đường cong mờ phía sau chính là hàm mật độ phân phối chuẩn, dùng làm thước đo để hiểu vì sao việc lấy mẫu không đều. Thử vài thao tác sau:
- Kéo Number of strata (K) lên cao: các chấm Stratified (hàng trên) tự động “dày” hơn ở vùng đỉnh chuông và “thưa” hơn ở hai đuôi, vì mỗi tầng chiếm đúng $1/K$ diện tích dưới đường cong, không phải chiều rộng trên trục hoành.
- Chấm Stratified (hàng trên) luôn trải đều và đối xứng, trong khi chấm Standard MC (hàng dưới) có thể dồn cụm ngẫu nhiên ở một vùng bất kỳ. Kéo Resimulate vài lần để thấy hàng dưới “nhảy” mỗi lần, còn hàng trên gần như không đổi hình dạng.
- Kéo Number of strata (K) lên mức cao nhất, rồi kéo Samples per stratum từ cao xuống thấp: bạn sẽ thấy hệ số Variance Reduction tăng lên đáng kể, vì tầng càng hẹp, phương sai trong tầng $\sigma_k^2$ càng nhỏ, hiệu quả càng cao.
- Nhìn bảng metrics phía dưới: khoảng tin cậy của SS luôn hẹp hơn hẳn Standard MC, minh chứng cho tính chất “không bao giờ tệ hơn” đã chứng minh trong phần lý thuyết.
Hạn chế của Stratified Sampling:
- SS giải quyết tốt việc rải đều mẫu, nhưng với các sự kiện cực kỳ hiếm như deep OTM, ngay cả việc rải đều cũng chỉ cho một tỷ lệ mẫu rất nhỏ rơi vào vùng ITM. Ta thử kéo Moneyness (So/K) xuống thấp trong Widget 1, SS cho sai lệch lớn, thậm chí cho giá bằng 0. Lúc này, thay vì chỉ chia tầng, ta cần Importance Sampling (xem Phần 2) để dịch chuyển toàn bộ tâm phân phối vào vùng ITM.
- SS hoạt động rất tốt khi phân tầng trực tiếp trên biến $Z$ một chiều dùng để mô phỏng payoff cuối kỳ như European Option. Nhưng với các Path-dependent Option cần hàng trăm bước thời gian, việc phân tầng đồng thời trên mọi chiều sẽ đòi hỏi $K^m$ tổ hợp tầng – bùng nổ tổ hợp ngay cả với $K$ và $m$ vừa phải. Đây chính là động lực dẫn tới kỹ thuật tiếp theo trong series, Quasi-Monte Carlo (xem Phần 3), vốn xử lý bài toán đa chiều một cách tinh tế hơn nhiều.
2. Importance Sampling: Lấy mẫu đúng nơi cần lấy
2.1. Trực giác qua trò chơi bốc bóng
Trước hết hãy hình dung ý tưởng của kỹ thuật này qua một trò chơi bốc bóng nhận thưởng sau đây.
Bài toán gốc
Một chiếc túi chứa 100 quả bóng: 99 bóng Đen và 1 bóng Đỏ. Nếu bốc được bóng Đen nhận 0, bốc được bóng Đỏ nhận 100. Phân phối gốc ($P$) như sau $P(Đen) = 0.99$, $P(Đỏ) = 0.01$.
Giá trị kỳ vọng thực tế là:
\[\mathbb{E}_P[\text{Phần thưởng}] = \underbrace{0.99 \times 0}_{\text{bóng Đen}} + \underbrace{0.01 \times 100}_{\text{bóng Đỏ}} = 1\]Nếu bốc ngẫu nhiên 20 lần từ túi gốc, khả năng rất cao là cả 20 lần đều ra bóng Đen. Ước lượng Monte Carlo khi đó bằng 0, sai số 100%, vì ta chưa bao giờ chạm tới bóng đỏ. Để ước lượng chính xác kỳ vọng khi có sự kiện hiếm gặp, ta cần tăng số lượng bốc bóng lên nhiều lần.
Ý tưởng đổi phân phối $P \rightarrow Q$
Ý tưởng ở đây là tạo túi bóng mới để bóng Đỏ xuất hiện thường xuyên hơn, sau đó dùng trọng số để hiệu chỉnh lại kỳ vọng theo thực tế.
-
Bước 1. Tạo phân phối mới $Q$: Tạo túi mới gồm 50 bóng Đen và 50 bóng Đỏ, hay $Q(\text{Đen}) = 0.5$, $Q(\text{Đỏ}) = 0.5$.
- Bước 2. Tính trọng số điều chỉnh $L$: Trọng số bằng tỷ số giữa xác suất gốc và xác suất mới, $L = P/Q$:
- Trọng số bóng Đen: $L_{\text{Đen}} = \frac{P(\text{Đen})}{Q(\text{Đen})} = \frac{0.99}{0.50} = 1.98$
- Trọng số bóng Đỏ: $L_{\text{Đỏ}} = \frac{P(\text{Đỏ})}{Q(\text{Đỏ})} = \frac{0.01}{0.50} = 0.02$
- Bước 3. Tính phần thưởng sau điều chỉnh: Mỗi lần rút được bóng, ta nhân phần thưởng với trọng số tương ứng.
- Rút bóng Đen, phần thưởng gốc $0$, phần thưởng sau điều chỉnh $0 \times 1.98 = 0$
- Rút bóng Đỏ, phần thưởng gốc $100$, phần thưởng sau điều chỉnh $100 \times 0.02 = 2$
Kiểm chứng phân phối mới $Q$
Bây giờ rút bóng từ túi mới, nơi bóng Đỏ xuất hiện 50% số lần, ta có kỳ vọng là:
\[\mathbb{E}_Q[\text{Phần thưởng} \times L] = \underbrace{0.50 \times 0}_{\text{bóng Đen}} + \underbrace{0.50 \times 2}_{\text{bóng Đỏ}} = 1\]Kết quả trùng khớp với giá trị kỳ vọng gốc! Bằng cách ép sự kiện hiếm (bóng Đỏ) xuất hiện thường xuyên hơn (từ 1% lên 50%), rồi giảm phần thưởng của nó xuống để bù trừ (từ 100 xuống 2), ta có thể thu thập được thông tin về phần thưởng ngay từ những lần thử đầu tiên, thay vì phải bốc hàng nghìn lần trong vô vọng như túi bóng gốc.
Trò chơi bốc bóng ở trên thực chất là một trường hợp đặc biệt của một kết quả tổng quát hơn nhiều trong lý thuyết xác suất Định lý Radon-Nikodym.
2.2. Cơ sở toán học: Định lý Radon-Nikodym
Cho không gian xác suất $(\Omega, \mathcal{F})$ với hai độ đo xác suất $P$ và $Q$. Nếu độ đo $P$ tuyệt đối liên tục đối với $Q$, ký hiệu $P \ll Q$, nghĩa là mọi biến cố có xác suất bằng 0 dưới $Q$ cũng có xác suất bằng 0 dưới $P$, định lý khẳng định tồn tại duy nhất một biến ngẫu nhiên $L \ge 0$ sao cho với mọi biến ngẫu nhiên $X$:
\[\mathbb{E}_P[X] = \mathbb{E}_Q[X \cdot L]\]Trong đó: $L = \frac{dP}{dQ}$ được gọi là Radon-Nikodym derivative hoặc likelihood ratio.
Điểm mấu chốt của định lý này là nó áp dụng cho mọi không gian xác suất, dù rời rạc như trò chơi bốc bóng, hay liên tục như phân phối dùng để mô phỏng giá cổ phiếu. Đây chính là nền tảng toán học vững chắc phía sau kỹ thuật IS mà ta sẽ áp dụng cho bài toán định giá quyền chọn phía sau.
2.3. Vấn đề: Định giá deep OTM Call
Hãy thử định giá một quyền chọn deep OTM bằng phương pháp Standard MC với bộ tham số sau: $S_0 = 100$, $K = 200$ (gấp đôi giá hiện tại), $T = 1$, $r = 5\%$, $\sigma = 20\%$
Để cổ phiếu tăng giá gấp đôi từ 100 lên 200 trong vòng một năm, chỉ với độ biến động 20% là một sự kiện cực kỳ hiếm. Dùng công thức Black-Scholes, ta tính được:
\[d_2 = \frac{\ln(S_0/K) + \left(r - \frac{\sigma^2}{2}\right)T}{\sigma\sqrt{T}} = \frac{\ln \left(100/200\right) + \left(0.05 - \frac{0.2^2}{2}\right)1}{0.2\sqrt{1}} \approx -3.3157\] \[N(d_2) \approx 0.00046\]Giá trị $N(d_2)$ chính là xác suất trung hòa rủi ro để quyền chọn kết thúc trong trạng thái có lãi $(S_T > K)$. Với xác suất có lãi chỉ khoảng 0.046%, giá quyền chọn theo lý thuyết sẽ là:
\[C_{BS} = S_0 N(d_1) - K e^{-rT} N(d_2) \approx \mathbf{0.0048}\]Một con số rất nhỏ, nhưng khác 0. Bây giờ hãy thử định giá bằng Monte Carlo với 10000 kịch bản. Vấn đề nằm ở chỗ: nếu xác suất ITM chỉ là 0.046%, thì trung bình chỉ có khoảng 4.6 trong số 10000 kịch bản cho ra payoff dương, 99.94% khối lượng tính toán bị lãng phí vào những kịch bản không đóng góp gì cho kết quả cuối cùng. Ngoài ra, phương sai của ước lượng lại phụ thuộc rất nhiều vào chính 4.6 kịch bản hiếm đó. Chỉ cần một lần chạy cho 6 kịch bản ITM thay vì 4.6, hay các kịch bản ITM tình cờ có giá lớn/nhỏ bất thường, kết quả cuối cùng sẽ dao động rất mạnh giữa các lần chạy.
Chạy thử Standard MC ta có kết quả sau:
Standard Monte Carlo
Price  : 0.0086
SE     : 0.0039
95% CI : [0.0009, 0.0163]
Nhìn vào sai số chuẩn (0.0039) so với giá trị ước lượng (0.0086), sai số tương đối lên tới hơn 45%. Khoảng tin cậy 95% dao động từ giá trị sát 0 đến hơn gấp đôi giá trị ước lượng. Đây là một kết quả gần như vô dụng cho mục đích định giá trong thực tế, dù đã dùng tới 10000 kịch bản.
Bài toán này thực ra không hiếm gặp trong thực tế. Các Quant thường cần định giá những kịch bản cực đoan khi tính tail risk, stress VaR, hay giá của các quyền chọn deep out-of-the-money, những nơi mà chính sự kiện hiếm mới là thứ quan trọng nhất cần đo lường chính xác.
2.4. Ý tưởng: Lấy mẫu quanh vùng ATM
Ý tưởng của Importance Sampling (IS) rất trực quan: tập trung tài nguyên tính toán vào các kịch bản thực sự có ý nghĩa đối với kết quả, rồi điều chỉnh lại với một trọng số hiệu chỉnh để giá trị kỳ vọng không bị chệch. Nhắc lại từ Bài 10. Monte Carlo Simulation, giá quyền chọn là một kỳ vọng dưới độ đo trung hòa rủi ro:
\[\mathbb{E}[f(X)] = \int_{-\infty}^{+\infty} f(x)\, p(x)\, dx \tag{13.7}\]Trong đó:
- $X$ là giá tài sản.
- $f(x)$ là hàm payoff của quyền chọn.
- $p(x)$ là hàm mật độ xác suất của $X$.
Giá tài sản $X$ có thể được mô phỏng bằng GBM qua công thức (10.11). Lưu ý ở đây ta thay $W_T^{\mathbb{Q}} = \sqrt{T}\, Z$ với $Z \sim \mathcal{N}(0,1)$ để thu được hàm biểu diễn $X$ theo biến $Z$ như sau:
\[X_T = X_0 \exp\!\left[\left({r} - \frac{\sigma^2}{2}\right)T + \sigma \sqrt{T}\, Z \right] \tag{13.8}\]Như vậy, thay vì thao tác kỹ thuật IS trên biến $X$ phân phối log-chuẩn, ta có thể làm trực tiếp trên biến $Z$ phân phối chuẩn tắc đơn giản hơn nhiều. Công thức (13.7) có thể biểu diễn lại theo biến $Z$:
\[\mathbb{E}[f(Z)] = \int_{-\infty}^{+\infty} f(z)\, \varphi(z)\, dz \tag{13.9}\]Trong đó:
- $Z$ là biến ngẫu nhiên theo phân phối chuẩn tắc.
- $\varphi(z)$ là hàm mật độ xác suất của $Z$.
Lấy mẫu từ phân phối khác
Bây giờ, thay vì lấy mẫu trực tiếp từ $\mathcal{N}(0,1)$ (các chấm xanh), ta lấy mẫu $Z$ từ một phân phối khác $\mathcal{N}(\theta, 1)$ (các chấm đỏ), một phiên bản dịch chuyển tâm sang $\theta$.
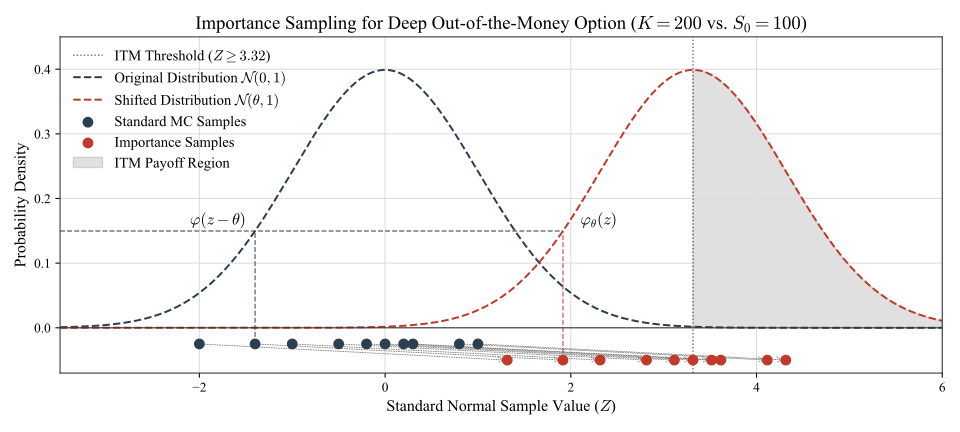
Hàm mật độ xác suất của phân phối mới có dạng $\varphi_\theta(z) = \varphi(z - \theta)$. Đẳng thức này được thể hiện một cách rất trực quan trên đồ thị, hai giá trị $z$, $z - \theta$ khác nhau gán vào hai hàm mật độ xác suất khác nhau lại cho cùng một giá trị trên trục tung. Nhân và chia cho $\varphi_\theta(z)$, tích phân (13.9) có thể viết lại như sau:
\[\begin{aligned} \mathbb{E}[f(Z)] &= \int_{-\infty}^{+\infty} f(z)\, \varphi(z)\, dz \\ &= \int_{-\infty}^{+\infty} f(z)\, \underbrace{\frac{\varphi(z)}{\varphi_\theta(z)}}_{L(z)}\, \varphi_\theta(z)\, dz \\ &= \mathbb{E}_\theta\big[f(Z)\, L(Z)\big] \end{aligned} \tag{13.10}\]Trong đó:
- $\mathbb{E}_\theta[\cdot]$ ký hiệu kỳ vọng khi $Z$ được lấy mẫu từ $\mathcal{N}(\theta, 1)$.
- $L(z)$ được gọi là Radon-Nikodym derivative, hay likelihood ratio.
Công thức (13.10) cho thấy hoàn toàn có thể lấy mẫu $Z$ từ một phân phối lệch tâm $\mathcal{N}(\theta, 1)$, miễn là sau đó hiệu chỉnh lại từng quan sát dưới phân phối gốc với trọng số $L(z)$ thì ước lượng vẫn chính xác. Với hai phân phối chuẩn cùng phương sai 1 nhưng khác tâm, trọng số $L(z)$ có công thức đóng như sau:
\[\begin{aligned} L(z) &= \frac{\varphi(z)}{\varphi_\theta(z)} = \frac{\varphi(z)}{\varphi(z-\theta)} \\ &= \frac{\frac{1}{\sqrt{2\pi}} e^{-z^2/2}}{\frac{1}{\sqrt{2\pi}} e^{-(z-\theta)^2/2}} \\ &= \exp\!\left[-\frac{z^2}{2} -\frac{(z-\theta)^2}{2}\right] \\ &= \exp\!\left[-\theta z + \frac{\theta^2}{2}\right] \end{aligned} \tag{13.11}\]Chọn $\theta$ như thế nào?
Mục tiêu của việc dịch chuyển là đưa phần lớn khối lượng xác suất của phân phối lấy mẫu về vùng đóng góp vào payoff, tức vùng $S_T > K$. Cách chọn $\theta$ phổ biến và hiệu quả nhất là đặt tâm phân phối mới trùng với ranh giới thực hiện quyền chọn, tức điểm \(z^*\) mà tại đó \(S_T(z^) = K\) hay:
\[\theta = z^* = \frac{\ln(K/S_0) - \left(r - \dfrac{\sigma^2}{2}\right)T}{\sigma\sqrt{T}} \tag{13.12}\]Với cách chọn này, khi lấy mẫu từ phân phối lệch tâm $\mathcal{N}(\theta, 1)$, 50% kịch bản mô phỏng sẽ rơi vào vùng $S_T > K$ thay vì 0.046% như trước. Ta đã biến một sự kiện hiếm thành một sự kiện phổ biến, đổi lại việc phải nhân thêm trọng số $L(z)$ để hiệu chỉnh.
💬 Quant Interview Question 13.2: Nếu chọn $\theta$ quá lớn (dịch chuyển quá xa), điều gì sẽ xảy ra với Importance Sampling?
🗨️ Answer: Nếu $\theta$ quá lớn, phân phối lấy mẫu $\mathcal{N}(\theta, 1)$ sẽ đặt phần lớn khối lượng xác suất vào vùng có giá trị $z$ cao. Khi đó trọng số $L(z) = \exp(-\theta z + \theta^2/2)$ sẽ trở nên cực kỳ nhỏ vì $-\theta z$ rất âm khi cả $\theta$ và $z$ đều lớn và dương. Kết quả là hầu hết trọng số gần như bằng 0, chỉ một vài trọng số ngoại lệ rất lớn. Phương sai của ước lượng sẽ bùng nổ trở lại, thậm chí còn tệ hơn Standard MC ban đầu.
2.5. Ứng dụng: Định giá deep OTM Call
Trước khi viết code, hãy thử tính tay với $5$ kịch bản để thấy rõ IS hoạt động ra sao. Với bộ tham số ở Phần 2.3, ta tính được $\theta$ theo công thức (13.12).
\[\theta = \frac{\ln(K/S_0) - \left(r - \dfrac{\sigma^2}{2}\right)T}{\sigma\sqrt{T}} = \frac{\ln \left(200/100\right) - \left(0.05 - \frac{0.2^2}{2}\right)1}{0.2\sqrt{1}} \approx 3.3157\]Ví dụ: Giả sử ta lấy được 5 mẫu ngẫu nhiên từ phân phối chuẩn tắc $\mathcal{N}(0,1)$, dùng cho cả hai trường hợp so sánh, như sau: \(z = \{-0.50, 0.20, -1.00, 0.80, 0.30\}\)
Standard MC (lấy mẫu $z_{\text{std}} = z$ trực tiếp):
| Path | $Z_{\text{std}}$ | $S_T = S_0 e^{(r-\sigma^2/2)T + \sigma\sqrt{T}Z_{\text{std}}}$ | Payoff $max(S_T - K, 0)$ |
|---|---|---|---|
| 1 | $-0.50$ | $100 \times \exp(0.03 + 0.2 \times -0.50) = 93.24$ | $0.00$ |
| 2 | $0.20$ | $100 \times \exp(0.03 + 0.2 \times 0.20) = 107.25$ | $0.00$ |
| 3 | $-1.00$ | $100 \times \exp(0.03 + 0.2 \times -1.00) = 84.37$ | $0.00$ |
| 4 | $0.80$ | $100 \times \exp(0.03 + 0.2 \times 0.80) = 120.93$ | $0.00$ |
| 5 | $0.30$ | $100 \times \exp(0.03 + 0.2 \times 0.30) = 109.42$ | $0.00$ |
Cả 5 kịch bản đều cho payoff bằng 0! Ước lượng Standard MC cho sai số 100%, hoàn toàn không phản ánh được giá trị thật của quyền chọn (~0.0048). Đây chính là minh chứng cho vấn đề đã nêu ở Phần 2.3.
Importance Sampling (lấy mẫu $z_{\text{shifted}} = z_{\text{std}} + \theta$, với $\theta \approx 3.3157$):
| Path | $Z_{\text{std}} $ | $Z_{\text{shifted}} = Z_{\text{std}} + \theta$ | $S_T$ | Payoff | $L(Z_{\text{shifted}})$ | Payoff $\times L(Z_{\text{shifted}})$ |
|---|---|---|---|---|---|---|
| 1 | $-0.50$ | $2.82$ | $180.97$ | $0.00$ | $0.0215$ | $0.000$ |
| 2 | $0.20$ | $3.52$ | $208.16$ | $8.16$ | $0.0021$ | $0.0172$ |
| 3 | $-1.00$ | $2.32$ | $163.75$ | $0.00$ | $0.1129$ | $0.000$ |
| 4 | $0.80$ | $4.12$ | $234.70$ | $34.70$ | $0.0003$ | $0.0100$ |
| 5 | $0.30$ | $3.62$ | $212.37$ | $12.37$ | $0.0015$ | $0.0187$ |
Với $\theta$ dịch tâm phân phối sang bên phải, 2 trong 5 kịch bản vẫn cho payoff bằng 0, nhưng 3 kịch bản còn lại (số 2, 4 và 5) rơi vào vùng ITM với payoff đáng kể (8.16, 34.70 và 12.37). Giá ước lượng bằng IS sau khi được hiệu chỉnh với trọng số $L$:
\[e^{-0.05 \times 1} \times \frac{0 + 0.0172 + 0 + 0.0100 + 0.0187}{5} \approx 0.9512 \times 0.0092 \approx \mathbf{0.0087}\]Chỉ với 5 kịch bản, Importance Sampling đã cho ra một con số cùng bậc độ lớn với giá Black-Scholes thật (0.0048), trong khi đó Standard MC cho ra giá trị 0. Đây chính là sức mạnh của việc lấy mẫu thông minh: tập trung nguồn lực tính toán vào nơi thông tin thực sự nằm ở đó.
2.6. Thực hành Python
Bây giờ hãy triển khai bằng Python với số lượng mô phỏng lớn hơn nhiều. Hàm european_mc_is không quá khác biệt với hàm european_mc, ngoài hai điểm sau:
- Mẫu cần được lấy từ phân phối lệch tâm $\mathcal{N}(\theta, 1)$. Để làm điều này, ta lấy mẫu
epsnhư bình thường từ phân phối chuẩn tắc rồi cộng thêm một hằng sốthetalà ta đã có mẫu mớiZ = eps + theta. - Hiệu chỉnh payoff với trọng số
weights = np.exp(-theta * Z + 0.5 * theta**2)theo (13.11).
def european_mc_is(S, K, T, r, sigma, n_sim, option_type='call', theta=None, seed=32):
    np.random.seed(seed)
    sign = 1 if option_type == 'call' else -1

    if theta is None:
        theta = (np.log(K / S) - (r - 0.5 * sigma**2) * T) / (sigma * np.sqrt(T)) # theta, formula (13.12)

    eps = np.random.standard_normal(n_sim) # Generate random value from N(theta, 1)
    Z = eps + theta # Generate random value from N(theta, 1)
    S_T = S * np.exp((r - 0.5 * sigma**2) * T + sigma * np.sqrt(T) * Z)
    payoffs = np.maximum(sign * (S_T - K), 0)

    weights = np.exp(-theta * Z + 0.5 * theta**2) # likelihood ratio, formula (13.11)
    weighted_payoffs = payoffs * weights

    price = np.exp(-r * T) * weighted_payoffs.mean()
    se = np.exp(-r * T) * weighted_payoffs.std(ddof=1) / np.sqrt(n_sim)
    return price, se, theta
Ta thử định giá quyền chọn deep OTM European Call với bộ tham số ở trên với 10000 mô phỏng:
# Parameters
S, K, T, r, sigma, n_sim = 100.0, 200.0, 1.0, 0.05, 0.20, 10000

# Pricing
bs_price = black_scholes(S, K, T, r, sigma, 'call')
price_std, se_std = european_mc(S, K, T, r, sigma, n_sim, 'call')
price_is, se_is, theta = european_mc_is(S, K, T, r, sigma, n_sim, 'call')
Black-Scholes             : 0.0048
Standard MC   (n = 10000) : 0.0086 ± 0.0077
Importance S. (n = 10000) : 0.0048 ± 0.0001   (theta=3.3157)
Variance reduction factor : 3755x
Kết quả rất ấn tượng: cùng số lượng 10000 mô phỏng, IS cho ra giá gần như trùng khớp với giá Black-Scholes, với phương sai nhỏ hơn Standard MC tới 3755 lần. Nói cách khác, để đạt độ chính xác tương đương, ta sẽ cần tới hơn chục triệu kịch bản mô phỏng với Monte Carlo thông thường.
Một điểm cần lưu ý, Importance Sampling phát huy tác dụng mạnh nhất khi bài toán có tính chất sự kiện hiếm gặp rõ rệt như deep OTM, hàng rào ở xa trong Barrier Option, hay tính tail risk/VaR cực đoan. Với quyền chọn thông thường, lợi ích của kỹ thuật này thường không đáng kể vì phân phối gốc đã tự nhiên lấy mẫu tốt quanh vùng quan trọng rồi.
Trên đây là Widget so sánh trực quan hai phân phối xác suất $S_T$ cho Standard MC (vùng xám nhạt) và Importance Sampling (vùng xám đậm) khi định giá quyền chọn deep OTM.
- Kéo Moneyness (So/K) xuống thấp: vùng nhạt gần như “biến mất” ở phía bên phải đường Strike khiến hàng nghìn kịch bản bị lãng phí, trong khi vùng đậm vẫn hiện diện rõ ràng ngay tại đó. Theo dõi chỉ số % ITM (Std → IS): moneyness càng giảm, giá trị Std càng gần 0%, còn giá trị IS luôn quanh 50% nhờ $\theta$ đã dịch tâm đúng vào ranh giới thực hiện $K$.
- Kéo θ scale: quan sát vùng đậm dịch sai vị trí, chưa đủ xa hoặc đi quá xa. Nhìn cột Importance Sampling trong bảng metrics: SE sẽ tăng vọt khi $\theta$ bị chọn sai, đúng như phân tích đã cảnh báo.
- Kéo Resimulate: Standard MC dao động rất mạnh giữa các lần chạy với nhiều lần giá bằng 0, trong khi IS luôn ổn định quanh giá Black-Scholes.
- Kéo Moneyness (So/K) về mức ATM: lợi thế của IS gần như biến mất, thể hiện rõ kỹ thuật này mạnh nhất ở vùng sự kiện hiếm, không phải ở sự kiện thông thường.
3. Quasi-Monte Carlo: Khi “ngẫu nhiên” không còn là lựa chọn tốt nhất
3.1. Ý tưởng: Lấp đầy không gian mẫu một cách có chủ đích
Toàn bộ các kỹ thuật đã học, kể cả Stratified Sampling, đều giữ nguyên bản chất ngẫu nhiên của việc lấy mẫu. Quasi-Monte Carlo (QMC) có ý tưởng táo bạo hơn nhiều, bằng cách thay thế các số ngẫu nhiên dựa trên xác suất bằng sự xác định toán học.
Hãy hình dung bạn cần xếp 16 chiếc ghế trong một khán phòng hình vuông sao cho khán giả phân bố đều khắp phòng, không chỗ nào quá đông, không chỗ nào bỏ trống. Nếu bạn tung xúc xắc để quyết định vị trí từng ghế, gần như chắc chắn sẽ có những cụm ghế dồn lại một góc và những khoảng trống ở góc khác. Điều này hoàn toàn bình thường: ngẫu nhiên không có nghĩa là đều. Nhưng nếu bạn chủ động đặt ghế theo một lưới đều đặn (4x4), bạn đạt được sự phân bố hoàn hảo, đánh đổi sự ngẫu nhiên bằng sự xác định.
QMC hoàn toàn không sử dụng số ngẫu nhiên hay giả ngẫu nhiên. Thay vào đó, nó sử dụng các dãy số có độ lệch thấp như dãy Halton, Sobol, hoặc Faure [2][3]. Các dãy số này được thiết lập theo các quy tắc toán học chặt chẽ để luôn tự động điền vào các khoảng trống xác suất chưa được khai phá bởi các điểm mẫu trước đó, giúp phân bố mẫu đồng đều nhất có thể [1].
3.2. Cơ sở toán học: Độ lệch và bất đẳng thức Koksma-Hlawka
Để đo lường mức độ “đều” của một tập mẫu, ta cần một thước đo gọi là độ lệch sao (star discrepancy), với $n$ điểm \(\{x_1, \ldots, x_n\}\) trong không gian $[0,1)^d$, được định nghĩa như sau:
\[D_n^*(x_1,\ldots,x_n) = \sup_{a \in [0,1)^d} \left| \frac{A([0,a);\,n)}{n} - \text{vol}\big([0,a)\big) \right| \tag{13.12}\]Trong đó:
- $d$ là số chiều.
- $A([0,a);n)$ là số điểm trong tập rơi vào hộp $[0,a) = [0,a_1)\times\cdots\times[0,a_d)$.
- $\text{vol}([0,a))$ là thể tích lý thuyết của hộp đó.
Hãy tưởng tượng bạn có một mảnh đất $[0,1] \times [0,1]$ hình vuông 2 chiều ($d=2$), và bạn rải 100 viên sỏi lên đó. Bây giờ, bạn chọn một góc hình chữ nhật bất kỳ, từ gốc $(0,0)$ tới vị trí $(a_1, a_2)$. Giả sử hình chữ nhật này chiếm đúng 20% diện tích mảnh đất ($\text{vol} = 0.20$). Theo lý thuyết nếu sỏi rải đều, vùng này phải chứa đúng 20 viên sỏi, nhưng thực tế đếm được lại có 35 viên sỏi. Độ lệch ở vùng này là $\vert{}0.35 - 0.20\vert{} = 0.15$.
Nói ngắn gọn: \(D_n^*\) đo sai lệch tệ nhất giữa tỷ lệ điểm thực tế rơi vào một vùng, so với tỷ lệ lý thuyết mà vùng đó đáng được nhận. Độ lệch càng nhỏ, tập mẫu càng đều theo đúng nghĩa toán học.
Mối liên hệ giữa \(D_n^*\) và sai số tích phân Monte Carlo dựa trên bất đẳng thức Koksma-Hlawka [4]:
\[\left| \int_{[0,1)^d} f(u)\,du - \frac{1}{n}\sum_{i=1}^n f(x_i) \right| \;\leq\; V_{HK}(f) \cdot D_n^*(x_1,\ldots,x_n) \tag{13.13}\]Trong đó: $V_{HK}(f)$ là biến phân toàn phần Hardy-Krause của $f$ – một con số cố định đo mức độ gồ ghề của hàm cần tích phân, không phụ thuộc vào cách ta lấy mẫu.
Công thức (13.13) có thể hiểu một cách đơn giản như sau: Sai số mô phỏng $\le$ Độ khó của bài toán $\times$ Chất lượng của tập điểm. Độ lệch của tập điểm ảnh hưởng trực tiếp tới sai số tích phân: muốn giảm sai số, cần chọn tập điểm có \(D_n^*\) nhỏ hơn. Đây chính là nơi Quasi-Monte Carlo tỏa sáng:
- Với số giả ngẫu nhiên thông thường, độ lệch có bậc \(D_n^* = \mathcal{O}_p(1/\sqrt{n})\) – đúng bằng tốc độ hội tụ $\mathcal{O}(1/\sqrt{n})$ của Monte Carlo như đã học.
- Với các chuỗi có độ lệch thấp, có thể xây dựng độ lệch có bậc \(D_n^* = \mathcal{O}\!\left((\log n)^d / n\right)\) [2].
Với $d$ cố định, khi $n \to \infty$, toán tử $(\log n)^d / n$ tiến về $0$ nhanh hơn hẳn $1/\sqrt{n}$. Đây chính là cơ sở toán học lý giải tại sao Quasi-Monte Carlo có thể hội tụ nhanh hơn Monte Carlo một cách có hệ thống, không phải chỉ là may mắn của một lần cụ thể [3].
3.3. Xây dựng chuỗi Halton và Sobol
Cách đơn giản nhất để xây dựng một chuỗi có độ lệch thấp trong 1 chiều là chuỗi van der Corput. Với cơ số $2$, ta lấy chỉ số $n$, viết nó dưới dạng nhị phân, rồi đảo ngược các chữ số đó qua dấu phẩy thập phân:
| $n$ | Binary | Bit-reversal / Reversed | Value (base 2) |
|---|---|---|---|
| $1$ | $1$ | $0.1$ | $0.500$ |
| $2$ | $10$ | $0.01$ | $0.250$ |
| $3$ | $11$ | $0.11$ | $0.750$ |
| $4$ | $100$ | $0.001$ | $0.125$ |
| $5$ | $101$ | $0.101$ | $0.625$ |
| $6$ | $110$ | $0.011$ | $0.375$ |
| $7$ | $111$ | $0.111$ | $0.875$ |
Hãy quan sát điều kỳ diệu: chỉ với 4 điểm đầu tiên \(\{0.5,\ 0.25,\ 0.75,\ 0.125\}\), các điểm đã trải khá đều trên $[0,1)$. Sau đúng 8 điểm, chuỗi sẽ phủ kín các vị trí \(\{1/8, 2/8, \ldots, 7/8\}\) một cách hoàn hảo. So sánh với việc sinh số ngẫu nhiên thực sự từ $U \sim \mathcal{U}(0,1)$, hoàn toàn có khả năng 4–5 trong số đó rơi gần nhau, để trống cả một mảng lớn.
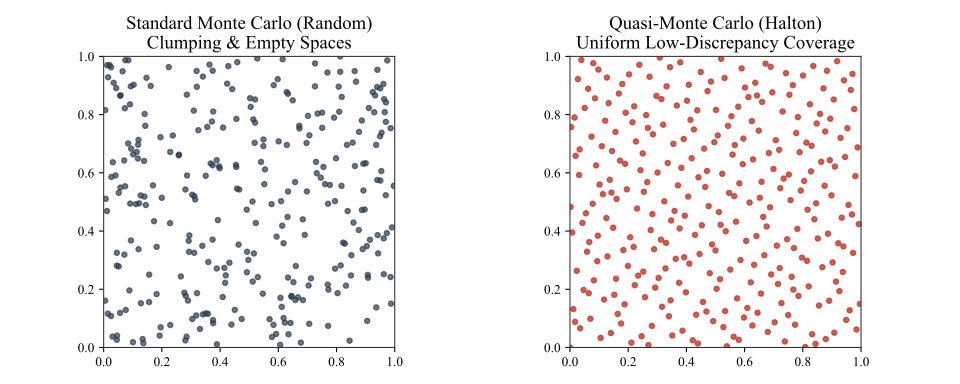
Chuỗi Halton, được giới thiệu bởi nhà toán học John H. Halton (1960), mở rộng ý tưởng này sang nhiều chiều: ở chiều $j$, dùng chuỗi van der Corput với cơ số là số nguyên tố $j$ ($2, 3, 5, 7, \ldots$), để đảm bảo các chiều không cộng hưởng với nhau. Tuy đơn giản và trực quan, Halton có nhược điểm là chất lượng suy giảm khá nhanh khi số chiều $d$ lớn, do các cơ số nguyên tố lớn tạo ra hiện tượng tương quan ẩn giữa các chiều [3] [4].
Chuỗi Sobol, được giới thiệu bởi nhà toán học người Nga Ilya M. Sobol (1967), dựa trên đa thức nguyên thủy (primitive polynomials) trên trường $GF(2)$ để sinh ra các số chỉ phương. Chuỗi Sobol phức tạp hơn về mặt xây dựng, nhưng duy trì được độ lệch cực thấp ngay cả khi số chiều lên tới hàng chục hoặc hàng trăm [3] [4].
Ta không cần đi sâu vào cách xây dựng chuỗi Halton hay chuỗi Sobol, mà có thể sử dụng trực tiếp trên thư viện có sẵn trong scipy.
💬 Quant Interview Question 13.3: Theo lý thuyết, sai số Quasi-Monte Carlo chịu ảnh hưởng của $(\log n)^d$, với $d$ là số chiều. Để đinh giá Path-dependent Option với 252 bước thời gian, $d=252$ là rất lớn, khiến $(\log n)^{252}$ trên lý thuyết vô cùng lớn. Vậy tại sao trong thực tế QMC vẫn được dùng sử dụng để định giá các sản phẩm phái sinh phức tạp?
🗨️ Answer: Mặc dù về mặt hình thức, mô phỏng một đường đi giá 252 bước cần 252 số ngẫu nhiên độc lập (hay 252 chiều danh nghĩa), nhưng phần lớn payoff của một quyền chọn thực tế thường bị chi phối chủ yếu bởi một vài vùng chính trên đường đi: ví dụ xu hướng tổng thể của cả đường đi quan trọng hơn nhiều so với dao động nhỏ ở bước thời gian thứ 200.
Thay vì mô phỏng đường đi giá theo thứ tự thời gian $t_1 \to t_2 \to \cdots \to t_{252}$, ta mô phỏng theo thứ tự quan trọng giảm dần: chiều đầu tiên (chất lượng cao nhất của chuỗi Sobol) dùng để xác định điểm cuối $S_T$, chiều thứ hai dùng để xác định điểm giữa, và cứ thế lấp đầy dần các điểm trung gian. Nhờ vậy, chiều hiệu dụng thực sự chỉ là một con số nhỏ, QMC vẫn cho tốc dộ hội tụ vượt trội trong thực tế định giá phái sinh phức tạp.
3.4. Thực hành Python
Thư viện scipy.stats.qmc đã tích hợp sẵn chuỗi Sobol. Ta chỉ cần sinh các điểm $U \in [0,1)$ theo Sobol, rồi biến đổi qua hàm nghịch đảo CDF chuẩn tắc để có $Z$, giống hệt cách ta đã làm với Stratified Sampling.
from scipy.stats import qmc

def european_qmc_sobol(S, K, T, r, sigma, m_power, option_type='call', seed=32):
    sign = 1 if option_type == 'call' else -1

    sampler = qmc.Sobol(d=1, scramble=True, seed=seed)
    U = sampler.random_base2(m=m_power)
    Z = norm.ppf(U[:, 0])

    S_T = S * np.exp((r - 0.5 * sigma**2) * T + sigma * np.sqrt(T) * Z)
    payoffs = np.maximum(sign * (S_T - K), 0)

    price = np.exp(-r * T) * payoffs.mean()
    return price, len(Z)
Trước tiên, ta thử định giá ATM European Call quen thuộc với Standard MC và Sobol QMC qua nhiều mức $n$ khác nhau.
# Parameters
S, K, T, r, sigma, n_sim = 100.0, 100.0, 1.0, 0.05, 0.20, 10000

# Pricing
bs_price = black_scholes(100, 100, 1.0, 0.05, 0.20, 'call')
for m_power in [6, 8, 10, 12, 14]:
    n_sim = 2**m_power
    price_std, se_std = european_mc(100, 100, 1.0, 0.05, 0.20, n_sim, 'call')
    price_qmc, n_actual = european_qmc_sobol(100, 100, 1.0, 0.05, 0.20, m_power, 'call')
n=    64 | Standard MC: 11.4010 (err=0.9504) | Sobol QMC: 10.4164 (err=0.0342)
n=   256 | Standard MC: 12.1976 (err=1.7470) | Sobol QMC: 10.4330 (err=0.0176)
n=  1024 | Standard MC: 10.7552 (err=0.3046) | Sobol QMC: 10.4487 (err=0.0019)
n=  4096 | Standard MC: 10.7370 (err=0.2864) | Sobol QMC: 10.4494 (err=0.0012)
n= 16384 | Standard MC: 10.7579 (err=0.3073) | Sobol QMC: 10.4497 (err=0.0009)
Kết quả rất ấn tượng: Sobol QMC tại mức 1024 đã chính xác hơn Standard MC tại mức 16384, tức với số kịch bản ít hơn 16 lần mà cho độ chính xác tương đương hoặc cao hơn. Sai số của Sobol QMC cũng giảm đều đặn gần như theo cấp số nhân khi n tăng gấp 4, nhanh hơn hẳn Standard MC.
Chuỗi Sobol gốc là hoàn toàn xác định, nên hai lần chạy sẽ cho cùng một kết quả, khiến ta không thể ước lượng được SE quen thuộc. Ta có thể dùng tham số scramble=True, để áp dụng một phép xáo trộn ngẫu nhiên có kiểm soát (scrambling, Owen, 1995 [8]) lên chuỗi Sobol, giữ nguyên tính chất độ lệch thấp, nhưng cho phép chạy lại nhiều lần độc lập để ước lượng sai số theo cách thông thường.
Bạn có thể tự tay điều chỉnh Widget 3 để xem sự khác biệt giữa mẫu của chuỗi van der Corput và Standard MC. Kéo $n = 2^m$ lên cao: các chấm van der Corput phân bổ rất đều, dày hơn ở vùng đỉnh và thưa hơn ở vùng đuôi. Nhìn bảng metrics phía dưới, giá QMC tiến sát giá Black Scholels và sai số giảm đi nhanh chóng.
Phiên bản Randomized QMC (scrambling QMC) có thể được xây dựng như sau:
def european_rqmc_sobol(S, K, T, r, sigma, m_power, n_replications=20, option_type='call'):
    sign = 1 if option_type == 'call' else -1
    prices = []
    for rep in range(n_replications):
        sampler = qmc.Sobol(d=1, scramble=True, seed=rep)
        U = sampler.random_base2(m=m_power)
        Z = norm.ppf(U[:, 0])
        S_T = S * np.exp((r - 0.5 * sigma**2) * T + sigma * np.sqrt(T) * Z)
        payoffs = np.maximum(sign * (S_T - K), 0)
        prices.append(np.exp(-r * T) * payoffs.mean())

    prices = np.array(prices)
    price = prices.mean()
    se = prices.std(ddof=1) / np.sqrt(n_replications)
    return price, se
Ta so sánh với Standard MC dùng: 10 lần lặp $\times$ 1024 điểm mỗi lần $=$ 10240 lần tính payoff:
# Pricing
n_reps, m_power = 10, 10
n_total = n_reps * 2**m_power
price_std, se_std = european_mc(100, 100, 1.0, 0.05, 0.20, n_total, 'call')
price_rqmc, se_rqmc = european_rqmc_sobol(100, 100, 1.0, 0.05, 0.20, m_power, n_reps, 'call')
Black-Scholes                : 10.4506
Standard MC (n=10240)        : 10.6421 ± 0.2871
RQMC Sobol  (10 reps × 1024) : 10.4503 ± 0.0039
Variance reduction factor    : 5399x
Sobol QMC giúp phương sai giảm tới 5399 lần, một mức giảm ấn tượng vượt xa mọi kỹ thuật đã học. Tuy nhiên đây là kết quả cho bài toán 1 chiều (payoff phụ thuộc duy nhất vào $S_T$), điều kiện lý tưởng nhất cho QMC. Với các bài toán nhiều chiều như Path-dependent Option với hàng trăm bước thời gian, mức giảm phương sai sẽ khiêm tốn hơn, nhưng vẫn có lợi thế lớn so với Standard MC.
4. Tóm tắt và thảo luận
Nhìn lại toàn bộ series kỹ thuật giảm phương sai, các kỹ thuật có sự đánh đổi rõ rệt giữa nỗ lực lập trình và hiệu quả mang lại.
| Techniques | Impl. Complexity | Efficiency | Remark [4]) |
|---|---|---|---|
| Moment Matching | Thấp | Trung bình | Dễ gặp lỗi bộ nhớ trong các mô phỏng lớn; gây phụ thuộc giữa các mẫu. |
| Antithetic Variates | Cực kỳ thấp | Thấp đến trung bình | Thích hợp làm bước đệm đầu tiên cho mọi mô phỏng nhờ tính đơn giản. |
| Control Variates | Trung bình | Cao (nếu tìm được biến tương quan mạnh) | Đảm bảo về mặt lý thuyết không bao giờ làm tăng phương sai. |
| Stratified Sampling | Cao | Cao | Loại bỏ hoàn toàn biến động giữa các tầng, chỉ giữ lại biến động nội bộ. |
| Importance Sampling | Rất cao | Vô cùng lớn (đặc biệt với các sự kiện hiếm) | Cực kỳ nhạy cảm: nếu chọn sai hàm mật độ mới, phương sai có thể bùng nổ lên vô hạn. |
| Quasi-Monte Carlo (QMC) | Trung bình | Rất cao | “Hộp đen” hiệu quả giúp tăng tốc độ hội tụ từ $\mathcal{O}(n^{-1/2})$ lên gần $\mathcal{O}(n^{-1})$. |
Không có kỹ thuật nào là vạn năng. Trong thực tế, các hệ thống định giá chuyên nghiệp thường kết hợp nhiều kỹ thuật cùng lúc (như Moment Matching + Antithetic) để tận dụng lợi thế của từng kỹ thuật.
- Hull, J. C. (2021). Options, Futures, and Other Derivatives (11th ed.). Pearson.
- Joshi, M. S. (2003). The Concepts and Practice of Mathematical Finance. Cambridge University Press.
- Haug, E. G. (2007). The Complete Guide to Option Pricing Formulas (2nd ed.). McGraw-Hill.
- Glasserman, P. (2004). Monte Carlo Methods in Financial Engineering. Springer.
- Boyle, P. P. (1977). Options: A Monte Carlo Approach. Journal of Financial Economics, 4(3), 323–338.
- Niederreiter, H. (1992). Random Number Generation and Quasi-Monte Carlo Methods. SIAM.
- Sobol, I. M. (1967). On the Distribution of Points in a Cube and the Approximate Evaluation of Integrals. USSR Computational Mathematics and Mathematical Physics, 7(4), 86–112.
- Owen, A. B. (1995). Randomly Permuted (t,m,s)-Nets and (t,s)-Sequences. In Monte Carlo and Quasi-Monte Carlo Methods in Scientific Computing, Springer, 299–317.