Bài 14: Định giá American Option với Longstaff-Schwartz Method (LSM)
Monte Carlo mô phỏng tiến, nhưng quyền thực hiện sớm của American Option cần quyết định lùi. Khám phá thuật toán Longstaff-Schwartz (2001) sử dụng hồi quy để giải quyết nghịch lý này. Ví dụ tính tay kinh điển và code Python chi tiết.
Trong các bài viết trước, chúng ta đã biết Monte Carlo là công cụ linh hoạt và mạnh mẽ nhất trong bộ ba phương pháp số, giúp định giá những sản phẩm phái sinh phức tạp như Path-dependent Option. Tuy nhiên, công cụ này lại gặp rất nhiều khó khăn khi định giá American Option.
Bài viết này giới thiệu thuật toán kinh điển Longstaff-Schwartz Method (LSM), do Francis A. Longstaff và Eduardo S. Schwartz công bố năm 2001 [1], được sử dụng rộng rãi để định giá các sản phẩm dạng này.
Trong bài viết này:
- 1. Thách thức: Vì sao Monte Carlo khó định giá American Option?
- 2. Ý tưởng của Longstaff-Schwartz: Hồi quy để ước lượng giá trị tương lai
- 3. Cơ sở toán học
- 4. Ví dụ kinh điển của Longstaff-Schwartz
- 5. Thực hành Python
- 6. Cạm bẫy thường gặp
- 7. Tóm tắt và thảo luận
1. Thách thức: Vì sao Monte Carlo khó định giá American Option?
Trong Bài 8. American Option, chúng ta đã biết rằng định giá quyền chọn kiểu Mỹ thực chất là một bài toán dừng tối ưu. Để quyết định xem có nên dùng quyền thực hiện sớm tại một thời điểm $t$ hay không, ta bắt buộc phải so sánh với giá trị của việc tiếp tục nắm giữ quyền chọn từ $t$ đến $T$ [2].
Với cây nhị phân, lời giải rất tự nhiên vì cấu trúc cây vốn dĩ đã “lùi” từ tương lai về hiện tại qua thuật toán truy hồi ngược. Tại mỗi nút, ta đã biết chính xác giá trị quyền chọn ở hai nút phía sau, nên phép so sánh bên dưới (14.1) luôn thực hiện được.
\[V_{i,j} = \max\Big(\underbrace{\text{Exercise Value}}_{\text{immediate exercise}},\ \underbrace{\text{Continuation Value}}_{\text{continued holding}}\Big) \tag{14.1}\]Ngược lại, Monte Carlo tiêu chuẩn là một phương pháp “tiến”. Mỗi đường đi giá là một quỹ đạo độc lập với nhau, bắt đầu từ thời điểm hiện tại $t$, hướng về tương lai cho đến ngày đáo hạn $T$. Làm sao có thể ước lượng giá trị kỳ vọng của việc nắm giữ quyền chọn khi chỉ có đúng một kịch bản tương lai duy nhất?
Hãy tưởng tượng bạn đang nắm giữ một American Put với giá thực hiện $K = 100$. Bạn mô phỏng được một đường đi giá cổ phiếu như sau:
\[S_0 = 100 \ \longrightarrow\ S_1 = 80 \ \longrightarrow\ S_2 = 105 \ \longrightarrow\ S_3 = 60\]Tại thời điểm $1$, giá cổ phiếu là 80, quyền chọn ITM với giá trị nếu thực hiện ngay là 20 $(K - S_1)$. Câu hỏi đặt ra là bạn nên thực hiện ngay và bỏ túi 20, hay tiếp tục giữ? Nếu chỉ nhìn vào đúng đường đi này, bạn sẽ thấy phần thưởng tại ngày đáo hạn là 40 ($K - S_3$), tính cả chiết khấu khả năng lớn vẫn lớn hơn 20, nên tiếp tục giữ có vẻ là quyết định đúng. Nhưng bạn đang nhìn trước tương lai của chính đường đi mà mình đang đứng trên đó. Trong thực tế, bạn hoàn toàn không biết giá sẽ tăng lên 105 rồi sau đó giảm mạnh xuống 60.
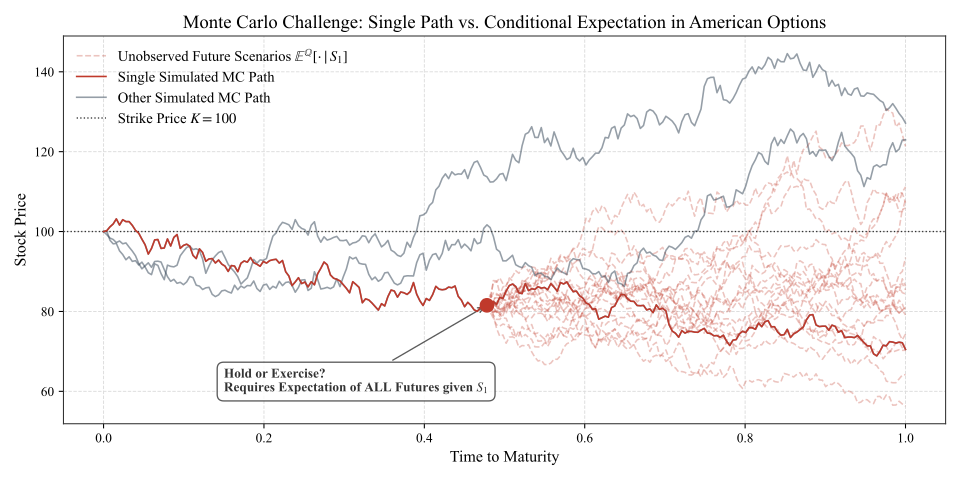
Quyết định thực hiện sớm phải dựa trên kỳ vọng trung bình của tất cả các kịch bản có thể xảy ra trong tương lai bắt đầu từ nút $t$ đó (các đường màu đỏ nét đứt, Hình 1). Một đường đi riêng lẻ (đường màu đỏ nét liền) không cho thông tin của toàn bộ kịch bản phía sau. Các đường mô phỏng khác xuất phát từ gốc (đường màu xanh) cũng không hữu ích vì ta cần các đường đi có điều kiện với giá tài sản bằng $St$ tại $t$. Vì vậy máy tính không có đủ cơ sở dữ liệu để so sánh và đưa ra quyết định [2].
Chính vì sự bất khả thi của Monte Carlo trong việc tính toán kỳ vọng có điều kiện tại từng nút, các nhà tài chính từng cho rằng quyền chọn kiểu Mỹ chỉ có thể định giá bằng các mô hình mạng lưới hoặc phương pháp sai phân hữu hạn. Tuy nhiên, các phương pháp này lại bất lực trước lời nguyền số chiều khi đối mặt với các quyền chọn phức tạp phụ thuộc đường đi hay phụ thuộc vào nhiều tài sản cơ sở. Longstaff và Schwartz (2001) đã đưa ra một giải pháp mang tính cách mạng [1].
2. Ý tưởng của Longstaff-Schwartz: Hồi quy để ước lượng giá trị tương lai
Giá trị tiếp tục tại thời điểm $t$ trên một đường đi có giá cổ phiếu $S_t$, được định nghĩa là kỳ vọng trung hòa rủi ro của toàn bộ dòng tiền tương lai chiết khấu về $t$:
\[F(t, S_t) = \mathbb{E}^{\mathbb{Q}}\Big[\, e^{-r(\tau - t)}\, f(S_\tau) \;\Big|\; S_t \,\Big] \tag{14.2}\]Trong đó:
- $f(\cdot)$ là hàm payoff.
- $\tau$ là thời điểm dừng tối ưu trong tương lai (tức là $\tau > t$).
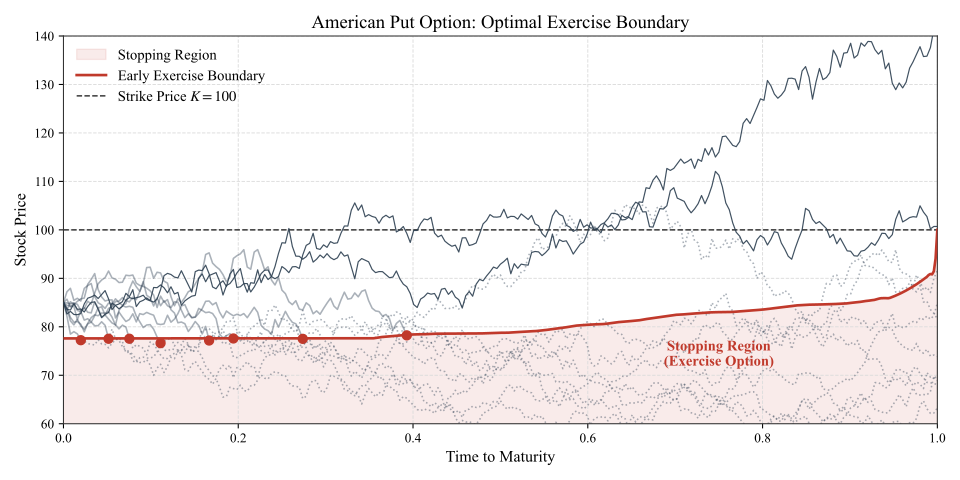
Cần chú ý $F(t, S_t)$ là một hàm số theo $S_t$, tức là một đường cong trơn liên tục theo giá cổ phiếu, chứ không phải một con số cố định. Nếu bạn biết chính xác hàm này, bài toán American Option coi như đã được giải trọn vẹn, chỉ cần so sánh $f(S_t)$ với $F(t, S_t)$ tại từng bước $t$.
Tuy nhiên, cố gắng suy ra $F(t, S_t)$ bằng công thức giải tích là điều gần như bất khả thi với hầu hết sản phẩm trong thực tế. Đây chính là lúc giải pháp của Longstaff và Schwartz phát huy sức mạnh. Họ đề xuất ước lượng hàm này bằng hồi quy bình phương nhỏ nhất trên chính tập hợp các đường đi đã mô phỏng [1]. Hình dưới đây minh họa hàm $F(t, S_t)$, theo thời gian và giá tài sản.
Trực giác rất đơn giản như sau: giả sử bạn có 10000 đường mô phỏng, tại thời điểm $t$, mỗi đường đi cho bạn hai thông tin:
- Biến độc lập ($X$): giá cổ phiếu $S_t$ trên đường đi đó tại thời điểm $t$.
- Biến phụ thuộc ($Y$): dòng tiền thực tế mà đường đi đó nhận được sau thời điểm $t$ (nếu tiếp tục giữ và hành động tối ưu ở các bước sau), đã chiết khấu về $t$.
Với 10000 cặp $(X_i, Y_i)$ như vậy, ta có đủ dữ liệu để chạy một phép hồi quy $Y$ theo $X$, và đường cong hồi quy chính là ước lượng của $F(t, S_t)$. Với một đường đi riêng lẻ, ta không biết giá trị tiếp tục là bao nhiêu, nhưng khi gộp hàng nghìn đường đi lại, quy luật thống kê sẽ tự hiện ra. Đây chính là tinh thần cốt lõi của Luật số lớn, được áp dụng một cách sáng tạo cho bài toán trên.
💬 Quant Interview Question 14.1: Tại sao không thể chỉ đơn giản lấy trung bình cộng của payoff tương lai trên tất cả các đường đi làm giá trị tiếp tục cho một mức giá $S_t$ cụ thể?
🗨️ Answer: Vì giá trị tiếp tục phải là một hàm số của $S_t$, chứ không phải một con số duy nhất cho toàn bộ kịch bản. Một đường đi có $S_t = 70$ và một đường đi khác có $S_t = 130$ chắc chắn có kỳ vọng dòng tiền tương lai rất khác nhau. Nếu chỉ lấy trung bình cộng thô của toàn bộ payoff tương lai bất kể $S_t$, ta sẽ trộn lẫn thông tin từ những kịch bản hoàn toàn không liên quan đến mức giá đang xét, làm sai lệch nghiêm trọng quyết định thực hiện sớm.
Ngược lại, hồi quy cho phép ta ước lượng $\mathbb{E}[Y \mid X = x]$ – kỳ vọng có điều kiện theo từng mức giá cụ thể – thay vì $\mathbb{E}[Y]$ vô điều kiện. Về bản chất, hồi quy đóng vai trò như một phép nội suy thông minh: nó tổng hợp thông tin từ tất cả các đường đi có $S_t$ gần với mức giá đang xét, rồi ước lượng đường cong giá trị tiếp tục mượt mà xuyên suốt toàn bộ miền giá trị của $S_t$.
3. Cơ sở toán học
3.1. Truy hồi ngược và ước lượng OLS
Giả sử ta chia kỳ hạn $[0, T]$ thành $m$ bước thời gian \(t_0 = \{0 < t_1 < \cdots < t_m = T \}\), và mô phỏng $n$ đường đi giá độc lập theo GBM dưới độ đo trung hòa rủi ro như công thức (10.13) đã học.
Tại ngày đáo hạn $t_m$, không có gì để so sánh vì ta luôn thực hiện nếu quyền chọn ITM và ngược lại. Thuật toán LSM chỉ xử lý từ $t_{m-1}$ về $t_1$. Tại mỗi bước $t_k$, ta có:
\[\hat{F}(t_k, S_{t_k}^{(i)}) = \sum_{p=0}^{P} \beta_p\, \psi_p\!\left(S_{t_k}^{(i)}\right) \tag{14.3}\]Trong đó: $\psi_0, \psi_1, \ldots, \psi_P$ là các hàm cơ sở (xem Phần 3.2), và $\beta_p$ là các hệ số hồi quy ước lượng bằng phương pháp bình phương nhỏ nhất như sau:
\[\boldsymbol{\beta} = \arg\min_{\boldsymbol{\beta}} \sum_{i \in \mathcal{I}_k} \left( Y_{t_k}^{(i)} - \sum_{p=0}^{P} \beta_p\, \psi_p\!\left(S_{t_k}^{(i)}\right) \right)^2 \tag{14.4}\]Trong đó:
- $\mathcal{I}_k$ là tập hợp các đường đi ITM tại thời điểm $t_k$. Phần 6.1 sẽ giải thích vì sao chỉ dùng ITM.
- $Y_{t_k}^{(i)}$ là dòng tiền thực tế mà đường đi $i$ nhận được sau $t_k$, chiết khấu về $t_k$, với giả định ta luôn thực hiện tối ưu ở các bước sau trong quá trình truy hồi ngược.
Sau khi có $\hat{F}(t_k, \cdot)$, quyết định thực hiện tại mỗi đường đi ITM $i$ sẽ là:
\[\text{Exercise if: } \quad f\!\left(S_{t_k}^{(i)}\right) \; > \; \hat{F}\!\left(t_k, S_{t_k}^{(i)}\right) \tag{14.5}\]Nếu điều kiện trên đúng, dòng tiền của đường đi $i$ tại $t_k$ được cập nhật thành $f(S_{t_k}^{(i)})$, và mọi dòng tiền đã ghi nhận ở các bước sau $t_k$ trên đường đi đó lập tức bị xóa bỏ vì quyền chọn đã được thực hiện, không còn tồn tại nữa. Lặp lại quá trình này lùi dần về $t_1$.
Cuối cùng, giá quyền chọn tại $t_0$ là trung bình của tất cả dòng tiền đã ghi nhận trên mỗi đường đi, chiết khấu đúng theo thời điểm mà dòng tiền đó xảy ra:
\[\hat{V}_0 = \frac{1}{n} \sum_{i=1}^{n} e^{-r\, \tau^{(i)}}\, h\!\left(S_{\tau^{(i)}}^{(i)}\right) \tag{14.6}\]Trong đó: $\tau^{(i)}$ là thời điểm dừng tối ưu của đường đi $i$.
3.2. Hàm cơ sở
Lựa chọn $\psi_p$ quyết định trực tiếp độ chính xác của ước lượng giá trị tiếp tục. Longstaff-Schwartz đề xuất dùng các đa thức đơn giản, và trong hầu hết trường hợp thực tế, chỉ cần bậc thấp là đủ [1]:
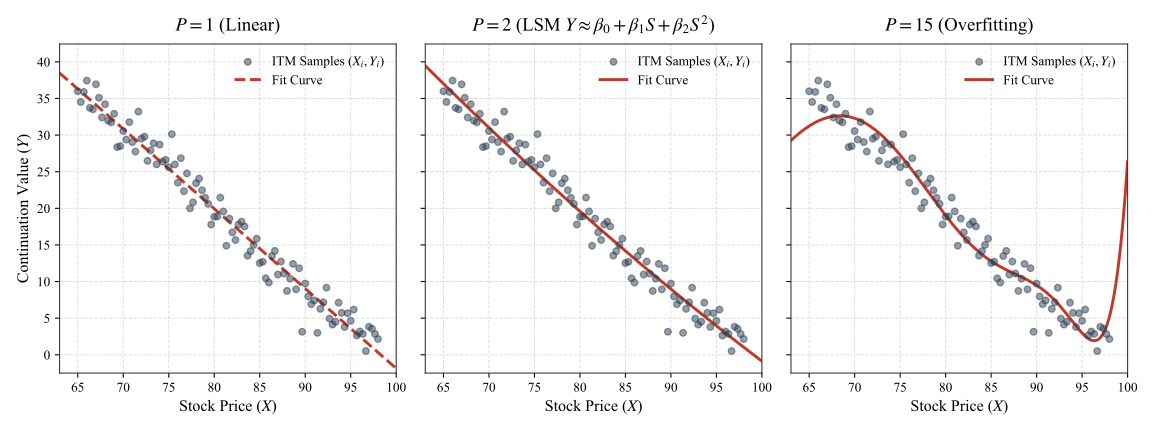
\[\psi_p(S) = S^p, \qquad p = 0, 1, 2, \ldots, P \tag{14.7}\]Trong bài báo gốc [1], Longstaff-Schwartz sử dụng đa thức bậc hai $P = 2$, $\psi_0 = 1$, $\psi_1 = S$, $\psi_2 = S^2$, hồi quy có thể được biểu diễn như sau:
\[Y \approx \beta_0 + \beta_1 S + \beta_2 S^2 \tag{14.8}\]Ngoài đa thức thông thường, người ta cũng hay dùng các đa thức trực giao như đa thức Laguerre hay đa thức Chebyshev để cải thiện tính ổn định số học khi $P$ lớn, hoặc bổ sung thêm các biến khác như giá trung bình của đường đi cho Path-dependent Option, hay các biến chéo cho Basket Option. Bậc $P$ càng cao, đường cong của hàm số càng linh hoạt, nhưng cũng dễ overfit nếu số lượng đường đi ITM không đủ lớn.
3.3. Thuật toán chi tiết
Tổng hợp lại, thuật toán LSM gồm các bước sau:
- Mô phỏng $n$ đường đi giá tài sản dưới đô đo trung hòa rủi ro $\mathbb{Q}$, từ $t_0$ đến $t_m$.
- Khởi tạo dòng tiền tại $t_m$: $\text{CF}^{(i)} = f(S_{t_m}^{(i)})$ với mọi $i$.
- Vòng lặp lùi từ $k = m-1$ về $k=1$:
- Lọc ra tập $\mathcal{I}_k$ các đường đi ITM tại $t_k$.
- Với mỗi đường đi $i \in \mathcal{I}_k$, tính $Y^{(i)}$ là dòng tiền hiện đang ghi nhận (ở bước gần nhất phía sau), chiết khấu về $t_k$.
- Hồi quy $Y$ theo $S_{t_k}$ trên tập $\mathcal{I}_k$ để có $\hat{F}(t_k, \cdot)$ theo (14.3)(14.4).
- So sánh $f(S_{t_k}^{(i)})$ với $\hat{F}(t_k, S_{t_k}^{(i)})$ theo (14.5). Nếu thực hiện, cập nhật dòng tiền tại $t_k$ và xóa mọi dòng tiền ở các bước sau trên đường đi đó.
- Tính giá quyền chọn bằng trung bình các dòng tiền đã ghi nhận, chiết khấu đúng thời điểm xảy ra, theo công thức (14.6).
Nhìn vào cấu trúc trên, LSM thực chất là một phiên bản “học được từ dữ liệu” của công thức (8.3) mà ta đã dùng cho cây nhị phân, ở bài trước. Khác biệt duy nhất là thay dựa trên hai nút con đã biết chính xác trên cây, giá trị tiếp tục được tính dựa vào đường hồi quy ước lượng từ dữ liệu mô phỏng.
4. Ví dụ kinh điển của Longstaff-Schwartz
Không có cách nào tốt hơn để hiểu thuật toán bằng ví dụ minh họa nổi tiếng nhất trong chính bài báo gốc [1]. Đây là ví dụ mà gần như mọi giáo trình Quant Finance hiện đại đều trích dẫn lại.
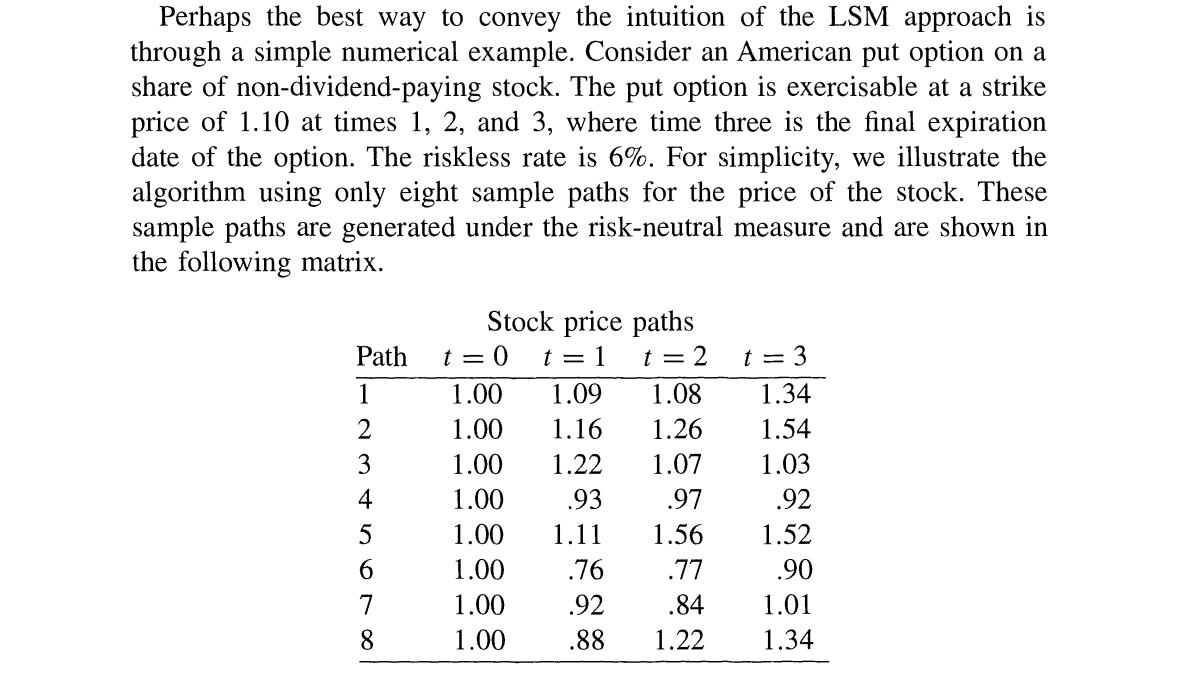
Ví dụ: Định giá một American Put với giá thực hiện $K = 1.10$, lãi suất phi rủi ro $r = 6\%$, kỳ hạn 3 năm chia thành 3 bước ($t=1,2,3$), dựa trên 8 mô phỏng đường đi giá cho sẵn như bảng dưới đây (giá ban đầu là 1.00 cho cả 8 đường đi).
Bước 1. Khởi tạo dòng tiền tại $t=3$
Payoff của American Put tại ngày đáo hạn là $\max(K - S_3, 0)$.
| Path | $S_0$ | $S_1$ | $S_2$ | $S_3$ | $\max(K - S_3, 0)$ |
|---|---|---|---|---|---|
| 1 | $1.00$ | $1.09$ | $1.08$ | $1.34$ | $0.00$ |
| 2 | $1.00$ | $1.16$ | $1.26$ | $1.54$ | $0.00$ |
| 3 | $1.00$ | $1.22$ | $1.07$ | $1.03$ | $0.07$ |
| 4 | $1.00$ | $0.93$ | $0.97$ | $0.92$ | $0.18$ |
| 5 | $1.00$ | $1.11$ | $1.56$ | $1.52$ | $0.00$ |
| 6 | $1.00$ | $0.76$ | $0.77$ | $0.90$ | $0.20$ |
| 7 | $1.00$ | $0.92$ | $0.84$ | $1.01$ | $0.09$ |
| 8 | $1.00$ | $0.88$ | $1.22$ | $1.34$ | $0.00$ |
Bảng dòng tiền cập nhật sau bước này:
| Path | $t=1$ | $t=2$ | $t=3$ |
|---|---|---|---|
| 1 | – | – | $0.00$ |
| 2 | – | – | $0.00$ |
| 3 | – | – | $\color{red}{0.07}$ |
| 4 | – | – | $\color{red}{0.18}$ |
| 5 | – | – | $0.00$ |
| 6 | – | – | $\color{red}{0.20}$ |
| 7 | – | – | $\color{red}{0.09}$ |
| 8 | – | – | $0.00$ |
Bước 2. Hồi quy tại $t=2$
Chỉ đường 1, 3, 4, 6, 7 ITM (tức $S_2 < K = 1.10$) mới tham gia hồi quy. Đường 2, 5, 8 OTM nên chắc chắn không tham gia, bị loại ngay từ đầu.
Đặt $r_0 = e^{-r \times 1} = e^{-0.06} \approx 0.9418$ là hệ số chiết khấu cho mỗi bước thời gian một năm. Với mỗi đường đi được chọn, ta lấy $X$ bằng giá cổ phiếu hiện tại và $Y$ là dòng tiền (ở bảng trên) chiết khấu về với hệ số $r_0$. Chạy hồi quy bậc hai $Y \approx \beta_0 + \beta_1 X + \beta_2 X^2$ trên 5 điểm dữ liệu này, ta được:
\[\hat{F}(2, S_2) \approx -1.070 + 2.983\, S_2 - 1.813\, S_2^2\]Thay $X$ vào phương trình trên để ước lượng giá trị tiếp tục $\hat{F}(\cdot)$, rồi so sánh với giá trị thực hiện ngay $\max(K-S_2,0)$, ta được:
| Path | $X = S_2$ | $Y = \text{Payoff}_{t=3} \times r_0$ | Continuation $\hat{F}(2,S_2)$ | Exercise $\max(K-S_2,0)$ | Optimal Decision |
|---|---|---|---|---|---|
| 1 | $1.08$ | $0.0000$ | $0.0367$ | $0.02$ | Hold |
| 3 | $1.07$ | $0.0659$ | $0.0459$ | $0.03$ | Hold |
| 4 | $0.97$ | $0.1695$ | $0.1175$ | $\mathbf{0.13}$ | Exercise |
| 6 | $0.77$ | $0.1884$ | $0.1520$ | $\mathbf{0.33}$ | Exercise |
| 7 | $0.84$ | $0.0848$ | $0.1564$ | $\mathbf{0.26}$ | Exercise |
Ba đường 4, 6, 7 có giá trị thực hiện ngay lớn hơn giá trị tiếp tục ước lượng, nên ta cập nhật lại dòng tiền của chúng tại $t=2$ bằng 0.13, 0.33, 0.26 tương ứng, và xóa bỏ dòng tiền tại $t=3$ trên các đường đi này. Đường 1, 3 vẫn giữ nguyên dòng tiền tại $t=3$ bằng 0 và 0.07.
Bảng dòng tiền cập nhật sau bước này:
| Path | $t=1$ | $t=2$ | $t=3$ |
|---|---|---|---|
| 1 | – | $0.00$ | $0.00$ |
| 2 | – | $0.00$ | $0.00$ |
| 3 | – | $0.00$ | $\color{red}{0.07}$ |
| 4 | – | $\color{red}{0.13}$ | $0.00$ |
| 5 | – | $0.00$ | $0.00$ |
| 6 | – | $\color{red}{0.33}$ | $0.00$ |
| 7 | – | $\color{red}{0.26}$ | $0.00$ |
| 8 | – | $0.00$ | $0.00$ |
Bước 3. Hồi quy tại $t=1$
Chỉ có đường đi 1, 4, 6, 7, 8 ITM tại $t=1$ (tức $S_1 < K = 1.10$).
Với mỗi đường đi, $Y$ là dòng tiền đang ghi nhận (ở bảng trên) chiết khấu về: với đường 1, 3 dòng tiền nằm ở $t=3$ nên chiết khấu $r_0^2$; với đường 4, 6, 7 dòng tiền đã chuyển về $t=2$ nên chỉ chiết khấu $r_0$.
Tiếp tục chạy hồi quy bậc hai trên $5$ điểm này, ta được:
\[\hat{F}(1, S_1) \approx 2.038 - 3.335\, S_1 + 1.356\, S_1^2\]So sánh với giá trị thực hiện ngay $\max(K - S_1, 0)$, ta được:
| Path | $X = S_1$ | $Y$ | Continuation $\hat{F}(1,S_1)$ | Exercise $\max(K-S_1,0)$ | Optimal Decision |
|---|---|---|---|---|---|
| 1 | $1.09$ | $0.0000$ | $0.0139$ | $0.01$ | Hold |
| 3 | $0.93$ | $0.1224$ | $0.1092$ | $\mathbf{0.17}$ | Exercise |
| 4 | $0.76$ | $0.3108$ | $0.2866$ | $\mathbf{0.34}$ | Exercise |
| 6 | $0.92$ | $0.2449$ | $0.1175$ | $\mathbf{0.18}$ | Exercise |
| 7 | $0.88$ | $0.0000$ | $0.1533$ | $\mathbf{0.22}$ | Exercise |
Bốn đường đi 4, 6, 7, 8 đều thực hiện sớm tại $t=1$. Ở đây có một điểm thú vị: đường 8 vốn ở trạng thái OTM tại $t=2$ ($S_2 = 1.22$) nên không tham gia hồi quy ở Bước 2, nhưng lại ITM tại $t=1$ ($S_1 = 0.88$) và được thực hiện ngay tại đây. Đây chính là minh chứng cho lý do vì sao thuật toán phải quét các đường ITM riêng biệt tại từng thời điểm, không thể gộp chung mọi đường.
Bảng dòng tiền cập nhật cuối cùng sau bước này:
| Path | $t=1$ | $t=2$ | $t=3$ |
|---|---|---|---|
| 1 | $0.00$ | $0.00$ | $0.00$ |
| 2 | $0.00$ | $0.00$ | $0.00$ |
| 3 | $0.00$ | $0.00$ | $\color{red}{0.07}$ |
| 4 | $\color{red}{0.17}$ | $0.00$ | $0.00$ |
| 5 | $0.00$ | $0.00$ | $0.00$ |
| 6 | $\color{red}{0.34}$ | $0.00$ | $0.00$ |
| 7 | $\color{red}{0.18}$ | $0.00$ | $0.00$ |
| 8 | $\color{red}{0.22}$ | $0.00$ | $0.00$ |
Bước 4. Tính giá quyền chọn
Chiết khấu từng dòng tiền về $t=0$ rồi lấy trung bình cộng của cả 8 đường đi:
\[\begin{aligned} \hat{V}_0 &= \frac{1}{8}\Big[ 0 + 0 + 0.07 r_0^3 + 0.17 r_0 + 0 + 0.34 r_0 + 0.18 r_0 + 0.22 r_0 \Big] \\ &= \frac{1}{8}\Big[ 0.0585 + 0.1601 + 0.3202 + 0.1695 + 0.2072 \Big] \\ &\approx \mathbf{0.1144} \end{aligned}\]Đây chính là kết quả nổi tiếng 0.1144 trong bài báo gốc [1]. Để thấy rõ giá trị của quyền thực hiện sớm, hãy so sánh với việc chỉ tính payoff tại ngày đáo hạn, tức định giá như một European Option, rồi chiết khấu đơn thuần 3 bước:
\[V_{\text{european}} = \frac{0 + 0 + 0.07 + 0.18 + 0 + 0.20 + 0.09 + 0}{8} \times 0.9418^3 \approx \mathbf{0.0564}\]American Put (0.1144) đắt hơn European Put (0.0564) gần gấp đôi, đúng như lý thuyết ta đã học: quyền thực hiện sớm luôn có giá trị dương hoặc bằng không, không bao giờ âm.
Để bạn có cảm nhận trực quan hơn về kỹ thuật hồi quy vừa tính tay ở trên, bạn có thể tự tay điều chỉnh Widget dưới đây để hiểu rõ hơn cơ chế quyết định của LSM:
Hàng nghìn đường đi được mô phỏng ngầm, mỗi chấm mờ là một đường đi ITM chọn tiếp tục giữ, mỗi chấm đậm là một đường đi ITM chọn thực hiện ngay. Đường liền nét chính là $\hat{F}(t,\cdot)$, đường đứt nét là giá trị thực hiện ngay $\max(K-S,0)$. Nơi hai đường này cắt nhau chính là ranh giới thực hiện tối ưu tại bước đó, và vùng mà đường liền nét nằm dưới đường đứt nét là vùng thực hiện ngay – tập trung dày đặc các chấm đậm.
- Kéo Moneyness (S₀/K) xuống thấp và kéo Step to inspect (k) từ phải qua, đường cong hồi quy tiến sát nằm ở phía dưới đường đứt nét. Về mặt lý thuyết vì khi quyền chọn deep ITM khả năng thực hiện sớm rất dễ xảy ra, các chấm đậm vì vậy xuất hiện lấn át chấm mờ.
- Thử tăng Moneyness (S₀/K) lên cao deep OTM ngay từ đầu: ở nhiều bước thời gian gần như không còn đường đi nào ITM, khi đó biểu đồ trống và % Exercised không hiển thị gì, đúng với việc thuật toán bỏ qua hoàn toàn những bước không có gì để quyết định.
- Kéo Nb of simulations (n) lên cao: đường cong hồi quy mượt và ổn định hơn hẳn, ít bị nhiễu bởi những điểm dữ liệu lẻ tẻ. Kéo xuống thấp và kéo Resimulate nhiều lần để thấy đường cong thay đổi khá mạnh giữa các lần chạy. Đây là minh chứng trực quan cho thấy LSM cần số lượng mô phỏng lớn.
5. Thực hành Python
5.1. Xây dựng thuật toán LSM
Bây giờ ta hiện thực hóa toàn bộ logic ở trên bằng Python, có thể mở rộng cho hàng chục nghìn đường đi và hàng trăm bước thời gian. Bạn có thể chạy thử trên Google Colab.
Trước tiên, ta tái sử dụng hàm simulate_paths từ Bài 10. Monte Carlo Simulation để mô phỏng giá tài sản theo GBM dưới độ đo trung hòa rủi ro. Hàm lsm_american triển khai chính xác 4 bước đã trình bày ở Phần 3.3:
cashflow: mảng lưu dòng tiền hiện tại của mỗi đường đi (khởi tạo bằng payoff tại ngày đáo hạn).exercise_time: mảng lưu thời điểm dòng tiền đó xảy ra, cần thiết để chiết khấu đúng số bước khi lùi về các thời điểm trước.for t in range(n_step - 1, 0, -1): vòng lặp lùi dần từ $t_{m-1}$ về $t_1$.np.vstack([X**p for p in range(degree + 1)]): xây dựng ma trận các hàm cơ sở (14.7).np.linalg.lstsq: ước lượng bình phương nhỏ nhất (14.4) để tìm hệ số hồi quy.
def lsm_american(S, K, T, r, sigma, n_step, n_sim, option_type='call', degree=2, seed=42):
    paths = simulate_paths(S, T, r, sigma, n_step, n_sim, seed)
    sign = 1 if option_type == 'call' else -1
    disc = np.exp(-r * T / n_step)

    def payoff(s):
        return np.maximum(sign * (s - K), 0)

    # --- 1. Payoff at maturity ---
    n_paths = paths.shape[0]
    cashflow = payoff(paths[:, -1]).copy()
    exercise_time = np.full(n_paths, n_step) # time index (in steps)

    # --- 2. Backward induction with regression ---
    for t in range(n_step - 1, 0, -1):
        St = paths[:, t]
        itm = payoff(St) > 0 # only regress on ITM paths
        if itm.sum() == 0:
            continue

        # Discount currently-recorded cashflow back to time t
        Y = cashflow[itm] * disc**(exercise_time[itm] - t)
        X = St[itm]
        A = np.vstack([X**p for p in range(degree + 1)]).T # basis functions
        coef, *_ = np.linalg.lstsq(A, Y, rcond=None) # formula (14.4)
        continuation_val = A.dot(coef) # formula (14.3)

        exercise_val = payoff(St[itm])
        exercise_now = exercise_val > continuation_val # formula (14.5)

        idx_itm = np.where(itm)[0]
        idx_exercise = idx_itm[exercise_now]
        cashflow[idx_exercise] = exercise_val[exercise_now] # overwrite: exercise now
        exercise_time[idx_exercise] = t # ...at time t

    # --- 3. Discount every path's realized cashflow back to time 0 ---
    pv = cashflow * disc**exercise_time
    price = pv.mean()
    se = pv.std(ddof=1) / np.sqrt(n_paths)
    return price, se
Đoạn code cashflow[idx_exercise] = exercise_val[exercise_now] rất quan trọng, ghi đè giá trị tại các đường itm. Vì cashflow là mảng một chiều, chỉ lưu một giá trị cho mỗi đường đi (không phải toàn bộ lịch sử), việc ghi đè này tự động giúp quy tắc được thực thi: nếu thực hiện sớm tại $t$, mọi dòng tiền tương lai (đã ghi nhận từ các vòng lặp trước) bị xóa bỏ. Đây chính là cách thực thi code gọn gàng nhất cho quy tắc tính tay ở Phần 4.
Bây giờ hãy định giá một American Put với bộ tham số: $S_0 = 100$, $K = 100$, $T = 1$, $r = 5\%$, $\sigma = 20\%$, đã dùng xuyên suốt từ Bài 8, để so sánh trực tiếp với kết quả từ cây nhị phân.
# Parameters
S, K, T, r, sigma = 100.0, 100.0, 1.0, 0.05, 0.20
n_step, n_sim = 252, 100000

price_lsm, se_lsm = lsm_american(S, K, T, r, sigma, n_step, n_sim, 'put', degree=2)
price_bm = binomial(S, K, T, r, sigma, 1000, 'put', 'american')
price_bs = black_scholes(S, K, T, r, sigma, 'put')
Black-Scholes                    : 5.5735
Binomial American (CRR, n=1000)  : 6.0896
LSM American (n=100000, m=252)   : 6.0725 ± 0.0439
Kết quả rất ấn tượng: LSM (6.0725) cho giá khá sát với cây nhị phân (6.0896), và cả hai đều xác nhận đặc quyền thực hiện sớm mang lại giá trị thặng dư khoảng ~0.52 so với European Put.
Một điều cần lưu ý là giá LSM hơi thấp hơn giá từ cây nhị phân. Đây không phải là ngẫu nhiên hay lỗi tính toán, mà là một đặc tính có hệ thống của thuật toán, sẽ được giải thích kỹ ở phần sau.
5.2. Ảnh hưởng của hàm cơ sở và số lượng mô phỏng
Ta thử thay đổi bậc đa thức degree để xem chất lượng hồi quy ảnh hưởng thế nào đến giá cuối cùng:
for deg in [1, 2, 3, 4]:
    p, se = lsm_american(S, K, T, r, sigma, n_step, n_sim, 'put', degree=deg)
    print(f"degree={deg}: price={p:.4f} ± {1.96*se:.4f}")
degree=1: price=5.9532 ± 0.0454
degree=2: price=6.0725 ± 0.0439
degree=3: price=6.0867 ± 0.0440
degree=4: price=6.0891 ± 0.0440
Xu hướng rõ ràng: bậc đa thức càng cao, đường cong giá trị tiếp tục càng linh hoạt, khiến quyết định thực hiện sớm càng chính xác. Ước lượng tiến gần hơn tới giá trị chuẩn (6.0896). Tuy nhiên lợi ích giảm rất nhanh sau bậc 3–4, trong khi số lượng biến hồi quy tăng nhanh gây gánh nặng lớn cho tính toán. Trong thực hành, đa số các nghiên cứu chỉ ra rằng định giá American Option chỉ cần bậc 2–3 là đủ [1][2].
Tiếp theo, ta thử nghiệm tốc độ hội tụ theo số lượng mô phỏng n_sim:
for n_simt in [1000, 5000, 10000, 100000]:
    p, se = lsm_american(S, K, T, r, sigma, n_step, n_simt, 'put', degree=2)
    print(f"n_sim={n_simt}: price={p:.4f} ± {1.96*se:.4f}")
n_sim=1000: price=6.1242 ± 0.4147
n_sim=5000: price=6.1534 ± 0.1965
n_sim=10000: price=6.1329 ± 0.1384
n_sim=100000: price=6.0725 ± 0.0439
Kết quả cho thấy sai số chuẩn (SE) giảm dần theo đúng tốc độ $\mathcal{O}(1/\sqrt{n})$ như mọi ước lượng Monte Carlo khác. Với n_sim nhỏ (như 1000), số lượng đường đi ITM dùng để hồi quy tại mỗi bước thời gian sẽ ít, khiến hệ số hồi quy kém ổn định. Đây chính là lý do LSM thường cần số lượng mô phỏng lớn hơn hẳn so với định giá European Option thông thường để đạt cùng độ chính xác, vì mỗi vòng lặp đều làm mất mát một phần thông tin thống kê.
Widget dưới đây trực quan hóa tốc độ hội tụ. Đường LSM price (đường đậm có khoảng tin cậy bao quanh) thường xuất phát thấp hơn đường Binomial price (đường đứt nét) khi $n$ còn nhỏ, rồi từ từ tăng lên và hội tụ dần về phía đường tham chiếu khi $n$ tăng.
- Kéo Regression degree từ 1 lên 4: quan sát đường LSM price dịch chuyển gần sát vào đường Binomial price ngay cả ở vùng có cùng số lượng mô phỏng, xác nhận rằng chất lượng hồi quy, chứ không chỉ số lượng mô phỏng, mới là yếu tố quyết định [độ chệch][do_chech].
- Kéo Moneyness (S₀/K) để thử các quyền chọn ITM/OTM khác nhau: chênh lệch giữa hai phương pháp (chỉ số Bias vs Binomial) thường lớn hơn ở vùng deep ITM, nơi việc thực hiện sớm có ý nghĩa quyết định nhất và sai số hồi quy là lớn nhất.
6. Cạm bẫy thường gặp
6.1. Chỉ hồi quy trên các đường đi ITM
Vì sao Longstaff-Schwartz chỉ chạy hồi quy trên các đường đi ITM thay vì dùng toàn bộ đường đi? Có hai lý do chính sau đây:
- Ý nghĩa tài chính: Quyết định thực hiện sớm chỉ có ý nghĩa khi quyền chọn đang ITM. Nếu $S_t \geq K$ với quyền chọn bán, giá trị thực hiện ngay bằng 0, và không ai dại gì thực hiện một quyền chọn vô giá trị. Bao gồm các đường đi OTM vào hồi quy chỉ làm loãng dữ liệu bằng những điểm không liên quan đến quyết định thực sự cần đưa ra.
- Cải thiện chất lượng hồi quy: Longstaff-Schwartz chỉ ra rằng việc giới hạn tập hồi quy vào vùng ITM giúp đường cong $\hat{F}(t, \cdot)$ được ước lượng chính xác ngay tại vùng giá trị quan trọng nhất – nơi ranh giới thực hiện tối ưu thực sự nằm ở đó – thay vì bị kéo lệch bởi hàng nghìn điểm OTM có payoff luôn bằng 0 [1].
Trong ví dụ ở Phần 4, ta đã thấy rõ hệ quả thực tế của quy tắc này: tại thời điểm $t=2$, đường đi 2, 5, 8 hoàn toàn không tham gia hồi quy vì đang OTM. Nếu chẳng may vô tình bao gồm chúng, hệ số hồi quy sẽ bị nhiễu bởi ba điểm dữ liệu vô nghĩa, làm sai lệch quyết định cho cả những đường đi ITM thực sự quan trọng.
6.2. Look-ahead Bias: Thiên kiến tiên liệu
Nhắc lại Phần 1, quyết định thực hiện tại thời điểm $t$ tuyệt đối không được dựa trên bất kỳ thông tin nào xảy ra sau $t$ trên cùng đường đi đó, nếu không ta đang dùng chính tương lai để đưa ra quyết định hiện tại [2].
Thuật toán LSM tránh được lỗi này một cách khéo léo nhờ chính cấu trúc hồi quy. Hệ số $\beta_p$ tại thời điểm $t$ được ước lượng từ toàn bộ mặt cắt ngang tại đúng thời điểm $t$, sau đó áp dụng chung công thức $\hat{F}(t, \cdot)$ cho mọi đường đi. Không đường đi cụ thể nào “nhìn trộm” tương lai của chính nó – nó chỉ mượn thông tin thống kê tổng hợp từ những đường đi khác, những đường đi này về mặt logic hoàn toàn độc lập và không liên quan gì đến diễn biến tương lai của đường đi đang xét.
Tuy nhiên, một lỗi tinh vi hơn có thể xảy ra: nếu bạn dùng cùng một tập đường đi vừa để ước lượng hồi quy, vừa để tính giá cuối cùng (như code Phần 5.1), kết quả vẫn có một độ chệch nhỏ, vì hệ số hồi quy đã “học” từ chính những đường đi mà nó dùng để quyết định. Cách khắc phục triệt để nhất, thường dùng trong các hệ thống định giá chuyên nghiệp, là chia đôi bộ mô phỏng: một nửa dùng để ước lượng hệ số hồi quy (in-sample), nửa còn lại dùng để tính giá cuối cùng dựa trên các hệ số đã cố định (out-of-sample) [3].
6.3. Low-biased Estimator: Định giá thấp hơn giá trị thực
Định giá American Option bằng thuật toán LSM thường cho giá thiên lệch xuống (low-biased estimator) so với giá trị thật. Đây là tính chất cực kỳ quan trọng khi áp dụng LSM trong thực tế.
Giá trị tiếp tục $\hat{F}(t,\cdot)$ là một ước lượng từ hồi quy, không phải giá trị lý thuyết chính xác tuyệt đối. Với số lượng đường đi và bậc đa thức hữu hạn, luôn tồn tại một sai số ước lượng $\varepsilon = \hat{F} - F$ ngẫu nhiên khác 0. Thuật toán so sánh giá trị thực hiện ngay với $\hat{F}$ chứ không phải $F$ thật. Bất cứ khi nào sai số ước lượng khiến $\hat{F}$ tình cờ thấp hơn giá trị thật ngay tại vùng ranh giới thực hiện, thuật toán sẽ thực hiện sớm dù thực chất tiếp tục giữ mới là tối ưu. Ngược lại, khi $\hat{F}$ tình cờ cao hơn giá trị thật, thuật toán sẽ bỏ lỡ cơ hội thực hiện sớm đáng lẽ nên nắm bắt.
Hai loại sai lầm này không đối xứng về mặt tài chính. Ra quyết định sai luôn khiến bạn nhận về ít hơn giá trị tối ưu thực sự, bất kể sai lầm đó là thực hiện sớm hay giữ quyền chọn quá lâu. Do đó, chiến lược thực hiện được suy ra từ $\hat{F}$ (dù $\hat{F}$ có thể lệch theo cả hai hướng) luôn là một chiến lược dưới tối ưu, và giá trị kỳ vọng của một chiến lược dưới tối ưu không bao giờ vượt quá giá trị của chiến lược thực sự tối ưu. Đây chính là lý do LSM mang tính chất thiên lệch xuống có hệ thống.
Trong thực nghiệm ở Phần 5.1 và 5.2, hiện tượng này thể hiện rất rõ: LSM (6.0725 với degree=2) luôn cho giá thấp hơn giá trị chuẩn từ cây nhị phân (6.0896). Khi tăng bậc đa thức để cải thiện chất lượng hồi quy, giá ước lượng tăng dần lên (6.0891 với degree=4) tiệm cận giá trị thật.
Trong các hệ thống định giá chuyên nghiệp, người ta thường kết hợp LSM với một kỹ thuật bổ sung để tính ra một cận trên (high-biased estimator), ví dụ bằng phương pháp đối ngẫu như Rogers (2002), Haugh & Kogan (2004) [4][5], rồi dùng cả hai giá trị như một khoảng tin cậy cho giá trị thật, thay vì chỉ tin tưởng tuyệt đối vào một con số duy nhất từ LSM.
7. Tóm tắt và thảo luận
Trong bài viết này, chúng ta đã giải quyết một nghịch lý tưởng chừng không thể vượt qua: làm sao dùng Monte Carlo – công cụ vốn chỉ mô phỏng tiến – để định giá American Option, sản phẩm đòi hỏi tư duy lùi.
-
Ý tưởng: Thay vì cố gắng tính giá trị tiếp tục bằng công thức giải tích, Longstaff-Schwartz ước lượng bằng hồi quy bình phương nhỏ nhất trên chính tập hợp đường đi đã mô phỏng. Mỗi đường đi không tự biết tương lai của mình, nhưng khi gộp hàng nghìn đường đi lại, quy luật thống kê sẽ tự hiện ra.
-
Ưu điểm lớn nhất của LSM không nằm ở việc định giá American Option cơ bản (nơi cây nhị phân vẫn nhanh và chính xác hơn), mà ở khả năng mở rộng sang các sản phẩm nhiều chiều – Basket Option, hay American Path-dependent Option – nơi cây nhị phân gặp vấn đề bùng nổ tổ hợp, trong khi LSM chỉ cần thêm biến vào ma trận hồi quy.
-
Thực hành Python
Trong bài tiếp theo, chúng ta sẽ tìm hiểu về phương pháp sai phân hữu hạn công cụ cuối cùng trong bộ ba phương pháp số.
- Longstaff, F. A., & Schwartz, E. S. (2001). Valuing American Options by Simulation: A Simple Least-Squares Approach. The Review of Financial Studies, 14(1), 113–147.
- Glasserman, P. (2004). Monte Carlo Methods in Financial Engineering. Springer.
- Longstaff, F. A., & Schwartz, E. S. (2001). Notes on Bias in the Least-Squares Monte Carlo Estimator. Working Notes, UCLA Anderson School of Management.
- Rogers, L. C. G. (2002). Monte Carlo Valuation of American Options. Mathematical Finance, 12(3), 271–286.
- Haugh, M. B., & Kogan, L. (2004). Pricing American Options: A Duality Approach. Operations Research, 52(2), 258–270.
- Hull, J. C. (2021). Options, Futures, and Other Derivatives (11th ed.). Pearson.
- Joshi, M. S. (2003). The Concepts and Practice of Mathematical Finance. Cambridge University Press.